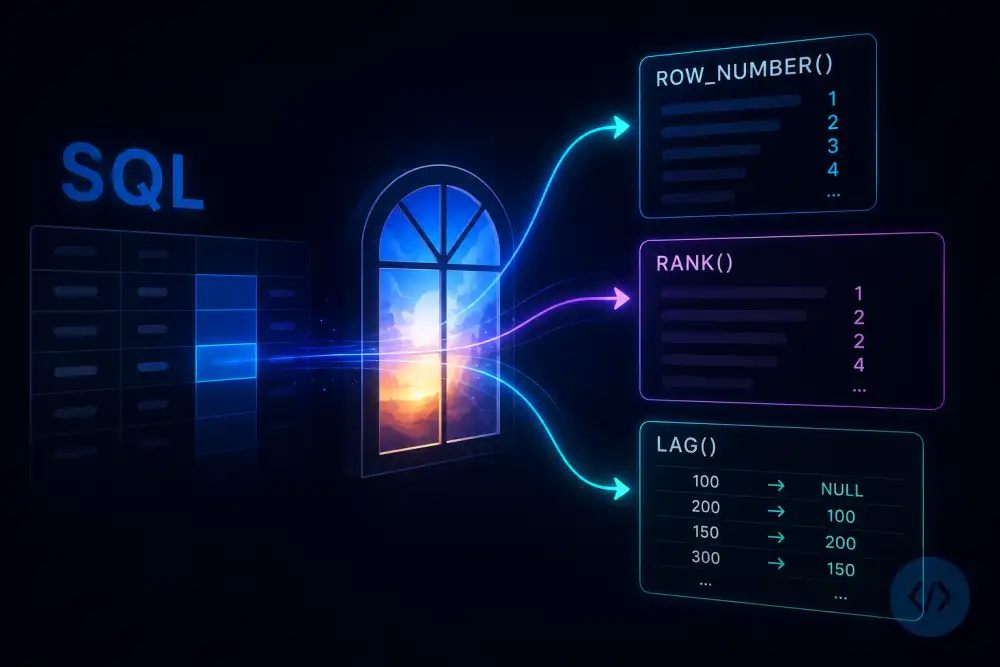
Las window functions (funciones de ventana) son una de las características más potentes de SQL moderno y una de las menos utilizadas por quienes no las conocen. Permiten hacer cálculos sobre un conjunto de filas relacionadas con la fila actual —sin colapsar el resultado en una sola fila como hace GROUP BY— lo que abre posibilidades que serían muy difíciles o imposibles con consultas tradicionales.
En esta guía vas a entender cómo funcionan, cuáles son las más importantes y cómo aplicarlas a problemas reales de análisis de datos.
El esquema de ejemplo
CREATE TABLE empleados (
  id             INT PRIMARY KEY,
  nombre         VARCHAR(100),
  departamento   VARCHAR(50),
  salario        DECIMAL(10, 2),
  fecha_ingreso  DATE
);

INSERT INTO empleados VALUES
  (1,  'Ana García',      'Ingeniería',  85000, '2020-03-15'),
  (2,  'Carlos López',    'Ingeniería',  72000, '2021-06-01'),
  (3,  'María Torres',    'Ingeniería',  95000, '2019-01-10'),
  (4,  'Jorge Ramírez',   'Ventas',      60000, '2022-02-20'),
  (5,  'Lucía Fernández', 'Ventas',      68000, '2021-09-05'),
  (6,  'Pedro Sánchez',   'Ventas',      55000, '2023-01-15'),
  (7,  'Elena Castro',    'Marketing',   78000, '2020-07-22'),
  (8,  'Roberto Díaz',    'Marketing',   82000, '2019-11-30'),
  (9,  'Isabel Moreno',   'Marketing',   74000, '2021-04-18'),
  (10, 'Diego Herrera',   'Ingeniería',  91000, '2018-08-09');

CREATE TABLE ventas (
  id          INT PRIMARY KEY,
  vendedor_id INT,
  mes         DATE,
  importe     DECIMAL(10, 2)
);

INSERT INTO ventas VALUES
  (1, 4, '2026-01-01', 12500),
  (2, 4, '2026-02-01',  9800),
  (3, 4, '2026-03-01', 14200),
  (4, 5, '2026-01-01', 18700),
  (5, 5, '2026-02-01', 21300),
  (6, 5, '2026-03-01', 16900),
  (7, 6, '2026-01-01',  7400),
  (8, 6, '2026-02-01',  8100),
  (9, 6, '2026-03-01',  9500);
La sintaxis base: OVER y PARTITION BY
Toda window function usa la cláusula OVER() que define la "ventana": el conjunto de filas sobre las que opera la función. Sin OVER() serías una función de agregación normal; con OVER() pasas a ser una window function.
-- Estructura general de una window function
funcion() OVER (
    PARTITION BY columna_de_agrupacion   -- opcional: dividir en grupos
    ORDER BY columna_de_orden            -- opcional: ordenar dentro de cada grupo
    ROWS|RANGE marco                     -- opcional: definir el rango de filas
)
-- La diferencia entre GROUP BY y OVER en la práctica:

-- GROUP BY: colapsa en una fila por grupo (pierdes el detalle individual)
SELECT departamento, AVG(salario) AS salario_medio
FROM empleados
GROUP BY departamento;
-- resultado: 4 filas (una por departamento)

-- OVER: mantiene todas las filas y añade el cálculo como columna extra
SELECT
  nombre,
  departamento,
  salario,
  AVG(salario) OVER (PARTITION BY departamento) AS salario_medio_dpto
FROM empleados;
-- resultado: 10 filas (todas las del empleado) con el promedio de su dpto
-- Salida de la consulta con OVER:
-- nombre           departamento  salario  salario_medio_dpto
-- Ana García       Ingeniería    85000    85750.00
-- Carlos López     Ingeniería    72000    85750.00
-- María Torres     Ingeniería    95000    85750.00
-- Diego Herrera    Ingeniería    91000    85750.00
-- Jorge Ramírez    Ventas        60000    61000.00
-- Lucía Fernández  Ventas        68000    61000.00
-- Pedro Sánchez    Ventas        55000    61000.00
-- Elena Castro     Marketing     78000    78000.00
-- Roberto Díaz     Marketing     82000    78000.00
-- Isabel Moreno    Marketing     74000    78000.00
ROW_NUMBER: numerar filas
ROW_NUMBER() asigna un número secuencial a cada fila dentro de la partición, sin empates: cada fila recibe un número único aunque tenga el mismo valor en la columna de orden.
SELECT
  nombre,
  departamento,
  salario,
  ROW_NUMBER() OVER (
    PARTITION BY departamento
    ORDER BY salario DESC
  ) AS posicion_en_dpto
FROM empleados;

-- Salida:
-- nombre           departamento  salario  posicion_en_dpto
-- María Torres     Ingeniería    95000    1
-- Diego Herrera    Ingeniería    91000    2
-- Ana García       Ingeniería    85000    3
-- Carlos López     Ingeniería    72000    4
-- Lucía Fernández  Ventas        68000    1
-- Jorge Ramírez    Ventas        60000    2
-- Pedro Sánchez    Ventas        55000    3
-- Roberto Díaz     Marketing     82000    1
-- Elena Castro     Marketing     78000    2
-- Isabel Moreno    Marketing     74000    3
Caso de uso clásico: el empleado mejor pagado de cada departamento
-- Obtener solo el empleado con mayor salario de cada departamento
-- usando ROW_NUMBER() como filtro en una subconsulta
SELECT nombre, departamento, salario
FROM (
    SELECT
      nombre,
      departamento,
      salario,
      ROW_NUMBER() OVER (
        PARTITION BY departamento
        ORDER BY salario DESC
      ) AS rn
    FROM empleados
) ranked
WHERE rn = 1;

-- Salida:
-- nombre         departamento  salario
-- María Torres   Ingeniería    95000
-- Lucía Fernández Ventas       68000
-- Roberto Díaz   Marketing     82000

-- Nota: si hay empate en el salario más alto, solo aparece UNO (el que elige el motor)
-- Si quieres que aparezcan todos los empatados, usa RANK() o DENSE_RANK()
-- Paginación eficiente con ROW_NUMBER (alternativa a LIMIT/OFFSET)
-- Para obtener la "página 3" con 3 resultados por página:
SELECT nombre, departamento, salario
FROM (
    SELECT
      nombre,
      departamento,
      salario,
      ROW_NUMBER() OVER (ORDER BY salario DESC) AS rn
    FROM empleados
) paginado
WHERE rn BETWEEN 7 AND 9;   -- página 3 (filas 7, 8, 9)
RANK y DENSE_RANK: clasificaciones con empates
Cuando hay empates en la columna de orden, RANK() y DENSE_RANK() los gestionan de forma diferente a ROW_NUMBER():
RANK(): los empatados reciben el mismo número, y el siguiente número "salta" los que se han compartido. Si dos filas son la número 2, la siguiente es la número 4 (no 3).DENSE_RANK(): los empatados reciben el mismo número, pero el siguiente número es consecutivo. Si dos filas son la número 2, la siguiente es la número 3.
-- Comparar las tres funciones con salarios que tienen empate
SELECT
  nombre,
  salario,
  ROW_NUMBER() OVER (ORDER BY salario DESC) AS row_num,
  RANK()       OVER (ORDER BY salario DESC) AS rank_val,
  DENSE_RANK() OVER (ORDER BY salario DESC) AS dense_rank_val
FROM empleados;

-- Salida (columnas clave):
-- nombre          salario  row_num  rank  dense_rank
-- María Torres    95000    1        1     1
-- Diego Herrera   91000    2        2     2
-- Ana García      85000    3        3     3
-- Roberto Díaz    82000    4        4     4
-- Elena Castro    78000    5        5     5
-- Isabel Moreno   74000    6        6     6
-- Carlos López    72000    7        7     7
-- Lucía Fernández 68000    8        8     8
-- Jorge Ramírez   60000    9        9     9
-- Pedro Sánchez   55000    10       10    10

-- (En este caso no hay empates, para ilustrar bien la diferencia
-- añadamos un escenario hipotético con empate en 85000)

-- Si Ana García y Roberto Díaz ganasen ambos 85000:
-- nombre           salario  row_num  rank  dense_rank
-- María Torres     95000    1        1     1
-- Diego Herrera    91000    2        2     2
-- Ana García       85000    3        3     3      ← mismo rank
-- Roberto Díaz     85000    4        3     3      ← mismo rank
-- Elena Castro     78000    5        5     4      ← rank salta a 5, dense_rank a 4
-- Caso de uso: top 3 vendedores de cada mes (con empates)
SELECT mes, vendedor_id, importe, ranking
FROM (
    SELECT
      mes,
      vendedor_id,
      importe,
      DENSE_RANK() OVER (
        PARTITION BY mes
        ORDER BY importe DESC
      ) AS ranking
    FROM ventas
) clasificado
WHERE ranking <= 3;
LAG y LEAD: acceder a filas anteriores y posteriores
LAG() permite acceder al valor de una columna en la fila anterior dentro de la partición. LEAD() hace lo mismo pero con la fila siguiente. Son la herramienta perfecta para calcular variaciones, crecimientos y comparaciones período a período.
-- Sintaxis
LAG(columna, desplazamiento, valor_por_defecto)  OVER (ORDER BY ...)
LEAD(columna, desplazamiento, valor_por_defecto) OVER (ORDER BY ...)

-- El desplazamiento por defecto es 1 (fila inmediatamente anterior/siguiente)
-- El valor por defecto es NULL si no hay fila anterior/siguiente
-- Comparar las ventas de cada mes con el mes anterior
SELECT
  v.mes,
  e.nombre AS vendedor,
  v.importe,
  LAG(v.importe) OVER (
    PARTITION BY v.vendedor_id
    ORDER BY v.mes
  ) AS importe_mes_anterior,
  v.importe - LAG(v.importe) OVER (
    PARTITION BY v.vendedor_id
    ORDER BY v.mes
  ) AS variacion_absoluta,
  ROUND(
    (v.importe - LAG(v.importe) OVER (
      PARTITION BY v.vendedor_id
      ORDER BY v.mes
    )) / LAG(v.importe) OVER (
      PARTITION BY v.vendedor_id
      ORDER BY v.mes
    ) * 100, 2
  ) AS variacion_porcentual
FROM ventas v
JOIN empleados e ON e.id = v.vendedor_id
ORDER BY v.vendedor_id, v.mes;

-- Salida:
-- mes         vendedor         importe  mes_anterior  variacion  porcentaje
-- 2026-01-01  Jorge Ramírez    12500    NULL          NULL        NULL
-- 2026-02-01  Jorge Ramírez     9800    12500        -2700      -21.60
-- 2026-03-01  Jorge Ramírez    14200     9800         4400       44.90
-- 2026-01-01  Lucía Fernández  18700    NULL          NULL        NULL
-- 2026-02-01  Lucía Fernández  21300    18700         2600       13.90
-- 2026-03-01  Lucía Fernández  16900    21300        -4400      -20.66
-- LEAD: mostrar el siguiente mes para comparación hacia adelante
SELECT
  mes,
  vendedor_id,
  importe,
  LEAD(importe, 1, 0) OVER (
    PARTITION BY vendedor_id
    ORDER BY mes
  ) AS importe_mes_siguiente
FROM ventas;

-- Usar LAG con desplazamiento mayor (comparar con 2 meses atrás)
SELECT
  mes,
  vendedor_id,
  importe,
  LAG(importe, 2) OVER (
    PARTITION BY vendedor_id
    ORDER BY mes
  ) AS importe_hace_dos_meses
FROM ventas;
Funciones de valor: FIRST_VALUE, LAST_VALUE y NTH_VALUE
-- FIRST_VALUE: obtener el primer valor de la partición en el orden dado
SELECT
  nombre,
  departamento,
  salario,
  FIRST_VALUE(nombre) OVER (
    PARTITION BY departamento
    ORDER BY salario DESC
  ) AS mejor_pagado_dpto
FROM empleados;

-- LAST_VALUE necesita ajustar el marco para ver el último de toda la partición
-- Por defecto el marco es ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
-- lo que hace que "último" sea la fila actual, no el final de la partición
SELECT
  nombre,
  departamento,
  salario,
  LAST_VALUE(nombre) OVER (
    PARTITION BY departamento
    ORDER BY salario DESC
    ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING
  ) AS peor_pagado_dpto
FROM empleados;

-- NTH_VALUE: obtener el valor N-ésimo de la partición
SELECT
  nombre,
  departamento,
  salario,
  NTH_VALUE(nombre, 2) OVER (
    PARTITION BY departamento
    ORDER BY salario DESC
    ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING
  ) AS segundo_mejor_pagado
FROM empleados;
NTILE: dividir en grupos de igual tamaño
-- NTILE(n) divide las filas en n grupos de tamaño aproximadamente igual
-- Útil para crear cuartiles, deciles o percentiles

SELECT
  nombre,
  salario,
  NTILE(4) OVER (ORDER BY salario DESC) AS cuartil
FROM empleados;

-- Salida:
-- nombre           salario  cuartil
-- María Torres     95000    1     ← cuartil superior (top 25%)
-- Diego Herrera    91000    1
-- Ana García       85000    1     (10 empleados / 4 = 2.5 → cuartiles de 2-3 filas)
-- Roberto Díaz     82000    2
-- Elena Castro     78000    2
-- Isabel Moreno    74000    2
-- Carlos López     72000    3
-- Lucía Fernández  68000    3
-- Jorge Ramírez    60000    4
-- Pedro Sánchez    55000    4     ← cuartil inferior (bottom 25%)

-- Etiquetar los cuartiles de forma más descriptiva
SELECT nombre, salario,
  CASE NTILE(4) OVER (ORDER BY salario DESC)
    WHEN 1 THEN 'Alto'
    WHEN 2 THEN 'Medio-alto'
    WHEN 3 THEN 'Medio-bajo'
    WHEN 4 THEN 'Bajo'
  END AS banda_salarial
FROM empleados;
Totales acumulados y medias móviles con el marco de ventana
El marco de ventana (frame) define exactamente qué filas se incluyen en el cálculo respecto a la fila actual. Es la parte más avanzada de las window functions.
-- Total acumulado (running total): suma de todas las filas hasta la actual
SELECT
  mes,
  vendedor_id,
  importe,
  SUM(importe) OVER (
    PARTITION BY vendedor_id
    ORDER BY mes
    ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW   -- desde el inicio hasta aquí
  ) AS total_acumulado
FROM ventas
ORDER BY vendedor_id, mes;

-- Salida:
-- mes         vendedor  importe  total_acumulado
-- 2026-01-01  4         12500    12500
-- 2026-02-01  4          9800    22300
-- 2026-03-01  4         14200    36500
-- 2026-01-01  5         18700    18700
-- 2026-02-01  5         21300    40000
-- 2026-03-01  5         16900    56900
-- Media móvil de 3 meses (mes actual + 2 anteriores)
SELECT
  mes,
  vendedor_id,
  importe,
  ROUND(
    AVG(importe) OVER (
      PARTITION BY vendedor_id
      ORDER BY mes
      ROWS BETWEEN 2 PRECEDING AND CURRENT ROW   -- las 2 filas anteriores + la actual
    ), 2
  ) AS media_movil_3m
FROM ventas
ORDER BY vendedor_id, mes;

-- Salida:
-- mes         vendedor  importe  media_movil_3m
-- 2026-01-01  4         12500    12500.00   ← solo 1 fila disponible
-- 2026-02-01  4          9800    11150.00   ← media de 2 filas
-- 2026-03-01  4         14200    12166.67   ← media de 3 filas
-- Los marcos de ventana más usados:
-- ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW   → acumulado desde el inicio
-- ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING → toda la partición
-- ROWS BETWEEN 2 PRECEDING AND CURRENT ROW           → ventana deslizante de 3
-- ROWS BETWEEN 1 PRECEDING AND 1 FOLLOWING           → fila anterior, actual y siguiente
Tres consultas analíticas completas
1. Ranking de empleados con percentil dentro del departamento
SELECT
  nombre,
  departamento,
  salario,
  RANK() OVER (PARTITION BY departamento ORDER BY salario DESC) AS rank_dpto,
  ROUND(
    PERCENT_RANK() OVER (PARTITION BY departamento ORDER BY salario) * 100, 1
  ) AS percentil_dpto,
  ROUND(
    (salario - AVG(salario) OVER (PARTITION BY departamento))
    / AVG(salario) OVER (PARTITION BY departamento) * 100, 1
  ) AS pct_sobre_media_dpto
FROM empleados
ORDER BY departamento, salario DESC;
2. Análisis de variación mes a mes por vendedor
WITH ventas_con_lag AS (
  SELECT
    v.mes,
    e.nombre AS vendedor,
    v.importe,
    LAG(v.importe) OVER (PARTITION BY v.vendedor_id ORDER BY v.mes) AS mes_anterior,
    SUM(v.importe) OVER (PARTITION BY v.vendedor_id ORDER BY v.mes
      ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW) AS acumulado
  FROM ventas v
  JOIN empleados e ON e.id = v.vendedor_id
)
SELECT
  mes,
  vendedor,
  importe,
  mes_anterior,
  importe - mes_anterior       AS variacion,
  ROUND((importe - mes_anterior) / mes_anterior * 100, 1) AS crecimiento_pct,
  acumulado
FROM ventas_con_lag
ORDER BY vendedor, mes;
3. Los 2 empleados mejor pagados de cada departamento
SELECT nombre, departamento, salario, posicion
FROM (
  SELECT
    nombre,
    departamento,
    salario,
    DENSE_RANK() OVER (
      PARTITION BY departamento
      ORDER BY salario DESC
    ) AS posicion
  FROM empleados
) clasificado
WHERE posicion <= 2
ORDER BY departamento, posicion;

-- Salida:
-- nombre          departamento  salario  posicion
-- María Torres    Ingeniería    95000    1
-- Diego Herrera   Ingeniería    91000    2
-- Roberto Díaz    Marketing     82000    1
-- Elena Castro    Marketing     78000    2
-- Lucía Fernández Ventas        68000    1
-- Jorge Ramírez   Ventas        60000    2
Compatibilidad con MySQL y PostgreSQL
| Función | MySQL (desde 8.0) | PostgreSQL |
|---|---|---|
ROW_NUMBER() | ✓ | ✓ |
RANK() | ✓ | ✓ |
DENSE_RANK() | ✓ | ✓ |
LAG() / LEAD() | ✓ | ✓ |
FIRST_VALUE() / LAST_VALUE() | ✓ | ✓ |
NTH_VALUE() | ✓ | ✓ |
NTILE() | ✓ | ✓ |
PERCENT_RANK() | ✓ | ✓ |
Marco ROWS BETWEEN | ✓ | ✓ |
Resumen
- Las window functions calculan valores sobre un conjunto de filas relacionadas sin colapsar el resultado, a diferencia de
GROUP BY. - La clave es la cláusula
OVER():PARTITION BYdivide en grupos yORDER BYdefine el orden dentro de cada grupo. ROW_NUMBER()numera filas de forma única. Ideal para obtener el top 1 de cada grupo o para paginación.RANK()asigna el mismo número a los empatados y "salta" el siguiente.DENSE_RANK()hace lo mismo pero sin saltar.LAG()yLEAD()acceden a filas anteriores y posteriores dentro de la partición, perfectos para calcular variaciones período a período.NTILE(n)divide la partición en n grupos iguales: ideal para cuartiles, deciles y percentiles.- El marco de ventana (
ROWS BETWEEN) controla exactamente qué filas se incluyen en el cálculo: permite totales acumulados, medias móviles y más. - Disponibles en MySQL desde la versión 8.0 y en PostgreSQL desde versiones muy anteriores.
No hay comentarios todavía. Sé el primero en compartir tu opinión.