En 2009, Netflix tenía un problema serio. Su plataforma de streaming crecía a una velocidad que su infraestructura no podía soportar. Un solo fallo en cualquier parte del sistema podía dejar sin servicio a millones de usuarios. Desplegar una actualización menor requería parar y reiniciar toda la aplicación.
La solución que adoptaron no era nueva en teoría, pero nadie la había aplicado a esa escala: dividir la enorme aplicación en cientos de servicios pequeños e independientes, cada uno responsable de una sola función. Era el nacimiento del que posiblemente sea el caso más conocido de migración de monolito a microservicios.
Hoy, la misma decisión que enfrentó Netflix la enfrenta cualquier equipo que construye software: ¿monolito o microservicios? No hay una respuesta universal, pero sí hay criterios claros. Vamos a verlos.
¿Qué es una arquitectura monolítica?
Una arquitectura monolítica (o simplemente monolito) es aquella en la que todos los componentes de una aplicación — interfaz de usuario, lógica de negocio y acceso a datos — están integrados en un único bloque de código que se desarrolla, despliega y escala como una sola unidad.
No es un insulto. Es simplemente una forma de construir software. Y durante décadas fue la forma estándar, perfectamente válida para la mayoría de los casos.
ARQUITECTURA MONOLÍTICA

┌─────────────────────────────────────────────────┐
│                  APLICACIÓN                     │
│                                                 │
│  ┌───────────┐  ┌───────────┐  ┌────────────┐  │
│  │  Frontend │  │  Backend  │  │   Acceso   │  │
│  │   (UI)    │  │  (Lógica) │  │   a datos  │  │
│  └───────────┘  └───────────┘  └────────────┘  │
│                                                 │
│  ┌──────────┐  ┌──────────┐  ┌──────────────┐  │
│  │ Módulo   │  │ Módulo   │  │   Módulo     │  │
│  │ Usuarios │  │  Pagos   │  │  Inventario  │  │
│  └──────────┘  └──────────┘  └──────────────┘  │
│                                                 │
└─────────────────────────────────────────────────┘
                       │
               ┌───────┴───────┐
               │  BASE DE DATOS │
               │    ÚNICA       │
               └───────────────┘

Todo el código vive junto.
Se despliega todo junto.
Escala todo junto.
Cómo funciona internamente
En un monolito, los módulos se comunican entre sí directamente mediante llamadas a funciones o métodos dentro del mismo proceso. No hay red de por medio, no hay serialización de datos, no hay latencia de comunicación.
// En un monolito, módulo Pedidos llama directamente a Inventario
// sin pasar por red ni APIs externas

// Módulo Pedidos:
function crearPedido(clienteId, productoId, cantidad) {
    const usuario = UsuariosService.obtener(clienteId);   // llamada directa
    const stock   = InventarioService.verificar(productoId); // llamada directa

    if (stock >= cantidad) {
        InventarioService.reducir(productoId, cantidad);   // llamada directa
        PagosService.cobrar(usuario.tarjeta, calcularTotal());
        NotificacionesService.enviar(usuario.email, "Pedido confirmado");
    }
}
// Todo ocurre en el mismo proceso, en memoria
// Sin latencia de red, sin serialización
Ventajas del monolito
- ✅ Simplicidad inicial — un solo repositorio, un solo despliegue, un solo entorno
- ✅ Desarrollo rápido al principio — menos infraestructura que configurar, menos decisiones que tomar
- ✅ Depuración más fácil — todo el código está en un solo lugar, el stack trace es lineal
- ✅ Testing de integración directo — no hay que simular servicios externos
- ✅ Sin latencia de red — las llamadas internas son llamadas a función, no peticiones HTTP
- ✅ Menor coste operativo — un solo servidor, una sola base de datos, un solo proceso de despliegue
- ✅ Ideal para equipos pequeños — un equipo de 3 personas no necesita la infraestructura de Netflix
Desventajas del monolito
- ❌ Escalado todo o nada — si el módulo de imágenes necesita más recursos, tienes que escalar toda la aplicación, no solo ese módulo
- ❌ Despliegue arriesgado — cualquier cambio, por pequeño que sea, requiere redesplegar toda la aplicación
- ❌ Base de código creciente — con el tiempo se convierte en lo que los desarrolladores llaman "big ball of mud": imposible de entender en su totalidad
- ❌ Acoplamiento tecnológico — si empezaste con Java, toda la aplicación es Java. Cambiar de tecnología implica reescribir todo
- ❌ Fallo total — si hay un bug en el módulo de reportes, puede derribar toda la aplicación, incluyendo los pagos
- ❌ Equipos que se bloquean — varios equipos trabajando en el mismo código se pisan constantemente
¿Qué son los microservicios?
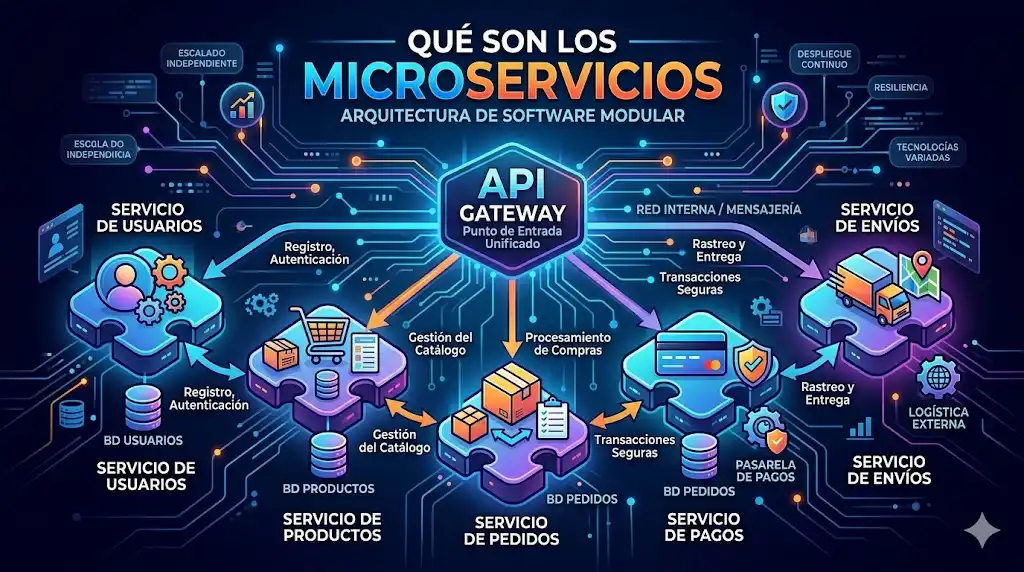
Una arquitectura de microservicios divide la aplicación en un conjunto de servicios pequeños, independientes y desplegables por separado, donde cada uno es responsable de una función de negocio específica y se comunica con los demás a través de interfaces bien definidas, típicamente APIs REST o mensajería asíncrona.
ARQUITECTURA DE MICROSERVICIOS

  ┌──────────────┐   ┌──────────────┐   ┌──────────────┐
  │   Servicio   │   │   Servicio   │   │   Servicio   │
  │   Usuarios   │   │    Pagos     │   │  Inventario  │
  │              │   │              │   │              │
  │   BD propia  │   │   BD propia  │   │   BD propia  │
  └──────┬───────┘   └──────┬───────┘   └──────┬───────┘
         │                  │                  │
         └──────────────────┼──────────────────┘
                            │
                    ┌───────┴───────┐
                    │  API GATEWAY  │  ← punto de entrada único
                    └───────┬───────┘
                            │
                         Cliente
                    (web, mobile, etc.)

Cada servicio:
  → Tiene su propio repositorio
  → Se despliega de forma independiente
  → Puede escalar de forma independiente
  → Puede usar tecnologías diferentes
  → Tiene su propia base de datos
Cómo se comunican los microservicios
La comunicación ya no es una llamada de función. Ahora hay red de por medio, y eso cambia todo.
// COMUNICACIÓN SÍNCRONA — HTTP/REST
// El servicio A espera la respuesta del servicio B

// Servicio de Pedidos llama al servicio de Inventario vía HTTP
const response = await fetch('http://inventario-service/api/stock/42');
const { disponible, cantidad } = await response.json();

if (disponible && cantidad >= cantidadSolicitada) {
    // proceder con el pedido
}

// Problema: si Inventario está caído, el pedido falla también
// Solución: Circuit Breaker, timeouts, reintentos con backoff

// ─────────────────────────────────────────────────────────────

// COMUNICACIÓN ASÍNCRONA — Mensajería (RabbitMQ, Kafka, SQS)
// El servicio A publica un evento y no espera respuesta

// Servicio de Pedidos publica un evento
await messageBroker.publish('pedido.creado', {
    pedidoId: '12345',
    clienteId: 'abc',
    items: [{ productoId: '42', cantidad: 2 }]
});
// El servicio de Pedidos continúa sin esperar

// Servicio de Inventario suscrito al evento:
messageBroker.subscribe('pedido.creado', async (evento) => {
    await reducirStock(evento.items);
    await messageBroker.publish('stock.actualizado', { ... });
});

// Servicio de Notificaciones también suscrito al mismo evento:
messageBroker.subscribe('pedido.creado', async (evento) => {
    await enviarEmailConfirmacion(evento.clienteId);
});

// Ventaja: desacoplamiento total. Si Notificaciones cae,
// Inventario y Pedidos siguen funcionando.
Ventajas de los microservicios
- ✅ Escalado independiente — si el servicio de búsqueda necesita más recursos en Black Friday, escalas solo ese servicio
- ✅ Despliegue independiente — el equipo de pagos puede publicar actualizaciones sin afectar al equipo de usuarios
- ✅ Libertad tecnológica — el servicio de ML puede estar en Python, el de pagos en Java, el de notificaciones en Go
- ✅ Resiliencia — si el servicio de recomendaciones falla, los pagos siguen funcionando
- ✅ Equipos autónomos — cada equipo es dueño de su servicio de principio a fin
- ✅ Base de código manejable — cada servicio es pequeño y completamente comprensible por el equipo responsable
- ✅ Actualización tecnológica gradual — puedes migrar un servicio a la vez sin reescribir todo
Desventajas de los microservicios
- ❌ Complejidad operativa alta — en lugar de un proceso, tienes 50. Cada uno necesita monitorización, logs, alertas y gestión de versiones
- ❌ Latencia de red — lo que antes era una llamada de función ahora es una petición HTTP con serialización, red y deserialización
- ❌ Consistencia de datos compleja — con múltiples bases de datos, las transacciones distribuidas son difíciles. Di adiós al ACID sencillo de SQL
- ❌ Testing de integración más difícil — necesitas simular o levantar múltiples servicios para probar flujos completos
- ❌ Coste de infraestructura mayor — múltiples servicios, bases de datos, redes internas, API gateways, orquestadores
- ❌ Requiere cultura DevOps madura — sin CI/CD, monitorización y observabilidad bien establecidos, los microservicios son un caos
- ❌ Debugging distribuido — rastrear un error que pasa por 5 servicios diferentes es significativamente más complejo que un stack trace lineal
La comparativa directa
| Característica | 🏛️ Monolito | 🔬 Microservicios |
|---|---|---|
| Base de código | Única, compartida por todos | Múltiples repositorios independientes |
| Despliegue | Todo a la vez | Cada servicio de forma independiente |
| Escalado | Toda la aplicación | Solo los servicios que lo necesitan |
| Base de datos | Una sola compartida | Una por servicio (idealmente) |
| Comunicación interna | Llamadas a función (en memoria) | API HTTP o mensajería (por red) |
| Tecnología | Una sola pila tecnológica | Cada servicio elige la suya |
| Equipos | Todos en el mismo código | Un equipo por servicio |
| Fallo de un módulo | Puede derribar toda la app | Solo afecta a ese servicio |
| Debugging | Sencillo — stack trace lineal | Complejo — trazas distribuidas |
| Testing | Integración directa y sencilla | Requiere mocks o entornos completos |
| Coste inicial | Bajo | Alto |
| Coste a gran escala | Alto (difícil de mantener) | Más controlado por servicio |
| Ideal para | Startups, MVP, equipos pequeños | Empresas grandes, equipos distribuidos |
Casos reales: cómo lo han vivido las grandes empresas
🎬 Netflix — el caso de éxito más citado
Netflix migró de un monolito a microservicios entre 2009 y 2012. Su razón principal: disponibilidad. Un fallo en cualquier parte del sistema monolítico afectaba a todos los usuarios. Con microservicios, si el servicio de recomendaciones falla, puedes seguir viendo tu película. Si el sistema de búsqueda se cae, los usuarios con una lista de reproducción preparada no notan nada.
Hoy Netflix tiene más de 700 microservicios en producción. Cada uno gestionado por un equipo autónomo. Sus sistemas de monitorización como Hystrix (Circuit Breaker) y Eureka (Service Discovery) se convirtieron en proyectos open source que toda la industria adoptó.
🛒 Amazon — el pionero
Amazon migró a microservicios alrededor de 2001, cuando Jeff Bezos envió su famosa carta interna ("Bezos Mandate") que decía, resumida: todo equipo debe exponer sus datos y funcionalidades a través de interfaces de servicio. Nadie puede comunicarse con otro equipo directamente. Solo a través de interfaces. No hay excepciones.
Esa decisión dio origen a AWS. Porque al construir servicios internos escalables, Amazon se dio cuenta de que podía ofrecerlos al mundo como infraestructura de nube.
📹 Amazon Prime Video — la vuelta al monolito
En 2023, Amazon Prime Video publicó un artículo que sacudió la industria: habían migrado su sistema de monitorización de calidad de vídeo de microservicios a un monolito y habían reducido los costes en un 90%. El sistema distribuido era demasiado caro para el volumen de datos que procesaba — cada frame de vídeo generaba eventos que viajaban entre servicios constantemente.
La lección no es que los microservicios sean malos. Es que son una herramienta para un problema específico, no una solución universal.
🎮 Stack Overflow — monolito orgulloso
Stack Overflow, uno de los sitios más visitados del mundo con millones de peticiones diarias, funciona con un monolito. En 2016 publicaron sus estadísticas de infraestructura: 9 servidores web manejando todo el tráfico. Su arquitectura es una gran aplicación .NET con una base de datos SQL Server. Y funciona perfectamente.
La razón: Stack Overflow tiene un equipo relativamente pequeño y un dominio bien definido. Los microservicios añadirían complejidad sin beneficio real.
El monolito modular — el término medio
Entre el monolito tradicional y los microservicios existe un enfoque intermedio que en 2026 es cada vez más popular: el monolito modular (también llamado "Majestic Monolith").
MONOLITO MODULAR

┌─────────────────────────────────────────────────┐
│                  APLICACIÓN                     │
│                                                 │
│  ┌──────────────────────────────────────────┐   │
│  │           Módulo Usuarios                │   │
│  │  (interfaz pública bien definida)        │   │
│  └──────────────────────────────────────────┘   │
│                                                 │
│  ┌──────────────────────────────────────────┐   │
│  │            Módulo Pagos                  │   │
│  │  (interfaz pública bien definida)        │   │
│  └──────────────────────────────────────────┘   │
│                                                 │
│  ┌──────────────────────────────────────────┐   │
│  │          Módulo Inventario               │   │
│  │  (interfaz pública bien definida)        │   │
│  └──────────────────────────────────────────┘   │
│                                                 │
└─────────────────────────────────────────────────┘
                       │
               ┌───────┴───────┐
               │  BASE DE DATOS │
               └───────────────┘

Ventajas:
  → Despliegue simple de monolito
  → Organización clara de microservicios
  → Fácil migrar a microservicios si lo necesitas
  → Sin latencia de red entre módulos
La idea es organizar el código del monolito con límites claros entre módulos, como si fueran microservicios, pero sin la sobrecarga operativa de serlo. Si en el futuro necesitas extraer un módulo como microservicio, ya está bien delimitado.
Shopify, GitHub y Basecamp son ejemplos exitosos de grandes empresas que usan monolitos bien organizados en lugar de microservicios.
Los patrones clave de microservicios que debes conocer
API Gateway — el punto de entrada único
// Sin API Gateway: el cliente conoce y llama a cada microservicio
Cliente → http://usuarios-service:3001/api/usuarios/42
Cliente → http://pedidos-service:3002/api/pedidos?clienteId=42
Cliente → http://productos-service:3003/api/productos/recomendados

// Con API Gateway: el cliente tiene un único punto de entrada
Cliente → https://api.miapp.com/usuarios/42
Cliente → https://api.miapp.com/pedidos?clienteId=42
Cliente → https://api.miapp.com/productos/recomendados

// El API Gateway se encarga de:
//  → Enrutar al servicio correcto
//  → Autenticación y autorización
//  → Rate limiting
//  → Logging centralizado
//  → SSL/TLS termination
Circuit Breaker — protegerse de fallos en cascada
// Problema: si el Servicio B se cae y A sigue llamándole,
// A también se bloquea y cae. Y C que llama a A también cae.
// Fallo en cascada → toda la aplicación cae.

// Circuit Breaker — 3 estados:
//
// CERRADO (normal):     las peticiones fluyen normalmente
//         ↓ (muchos errores)
// ABIERTO (fallo):      las peticiones fallan inmediatamente
//                       sin esperar al timeout. El servicio
//                       puede recuperarse sin ser bombardeado.
//         ↓ (tiempo de espera)
// SEMIABIERTO (prueba): deja pasar algunas peticiones para
//                       verificar si el servicio se recuperó.
//                       Si fallan → vuelve a ABIERTO
//                       Si tienen éxito → vuelve a CERRADO

// Implementación conceptual:
class CircuitBreaker {
    constructor(servicio, umbralFallos = 5, tiempoEspera = 30000) {
        this.servicio = servicio;
        this.fallos = 0;
        this.umbral = umbralFallos;
        this.estado = 'CERRADO';
        this.ultimoFallo = null;
        this.tiempoEspera = tiempoEspera;
    }

    async llamar(args) {
        if (this.estado === 'ABIERTO') {
            if (Date.now() - this.ultimoFallo > this.tiempoEspera) {
                this.estado = 'SEMIABIERTO';
            } else {
                // Fallo rápido — no esperamos al timeout
                throw new Error('Servicio no disponible (circuit abierto)');
            }
        }

        try {
            const resultado = await this.servicio(args);
            this.onExito();
            return resultado;
        } catch (error) {
            this.onFallo();
            throw error;
        }
    }

    onExito() {
        this.fallos = 0;
        this.estado = 'CERRADO';
    }

    onFallo() {
        this.fallos++;
        this.ultimoFallo = Date.now();
        if (this.fallos >= this.umbral) {
            this.estado = 'ABIERTO';
        }
    }
}
Saga — transacciones distribuidas
// PROBLEMA: sin base de datos compartida, no puedes hacer
// un COMMIT que afecte a múltiples servicios a la vez.

// SAGA: una secuencia de transacciones locales donde cada
// servicio publica un evento que dispara la siguiente transacción.
// Si algo falla, se ejecutan transacciones compensatorias.

// Ejemplo: proceso de compra

// Paso 1: Pedidos crea el pedido (estado: "pendiente")
//   → publica evento: pedido.creado

// Paso 2: Inventario reduce el stock
//   → Si OK: publica evento: stock.reducido
//   → Si ERROR: publica evento: stock.insuficiente
//              → Pedidos cancela el pedido (transacción compensatoria)

// Paso 3: Pagos cobra al cliente
//   → Si OK: publica evento: pago.realizado
//   → Si ERROR: publica evento: pago.fallido
//              → Inventario restaura el stock (compensatoria)
//              → Pedidos cancela el pedido (compensatoria)

// Paso 4: Pedidos actualiza estado a "confirmado"
//   → publica evento: pedido.confirmado

// Paso 5: Notificaciones envía el email de confirmación

// Cada paso es atómico en su propio servicio.
// La consistencia eventual garantiza que el sistema llegará
// a un estado coherente aunque no sea inmediato.
¿Cuándo elegir cada arquitectura? La guía de decisión
Empieza con un monolito cuando:
- ✅ Estás construyendo un MVP o validando una idea de negocio
- ✅ Tu equipo tiene menos de 10 desarrolladores
- ✅ El dominio del problema no está completamente definido todavía
- ✅ No tienes experiencia previa con sistemas distribuidos
- ✅ El presupuesto de infraestructura es limitado
- ✅ La velocidad de lanzamiento es la prioridad número uno
La regla clásica atribuida a Martin Fowler: "No empieces con microservicios. Empieza con un monolito, y cuando el monolito se vuelva un problema, extrae los servicios que necesites."
Migra a microservicios cuando:
- ✅ El monolito es tan grande que nadie lo comprende en su totalidad
- ✅ Diferentes partes de la aplicación necesitan escalar de forma muy diferente
- ✅ Múltiples equipos se bloquean entre sí constantemente
- ✅ Necesitas desplegar partes de la aplicación con frecuencias muy diferentes
- ✅ Tienes cultura DevOps madura: CI/CD, monitorización, observabilidad
- ✅ El coste operativo de los problemas del monolito supera el coste de migrar
El árbol de decisión simplificado
¿Cuántos desarrolladores tiene el equipo?
  < 10 personas → MONOLITO (o monolito modular)
  > 50 personas → MICROSERVICIOS (probablemente)
  Entre 10 y 50 → depende del punto siguiente

¿El dominio está bien definido y es estable?
  NO → MONOLITO (los límites de microservicios son difíciles de definir
                 si no conoces bien el negocio)
  SÍ → evalúa el siguiente punto

¿Diferentes partes necesitan escalar de forma radicalmente diferente?
  NO → MONOLITO (o monolito modular)
  SÍ → MICROSERVICIOS

¿Tienes CI/CD, monitorización y cultura DevOps establecidos?
  NO → MONOLITO (los microservicios sin operaciones maduras son un caos)
  SÍ → MICROSERVICIOS puede ser la elección correcta
Los errores más comunes al adoptar microservicios
❌ Empezar directamente con microservicios
Es el error más costoso. Si no conoces bien los límites de tu dominio, los microservicios que defines hoy estarán mal divididos mañana. Rehacer los límites entre microservicios en producción es enormemente costoso. Empezar con un monolito y extraer servicios cuando los límites están claros es casi siempre la decisión más inteligente.
❌ Microservicios demasiado pequeños ("nanoservicios")
// ❌ Demasiado granular — cada operación es un servicio
Servicio: obtener-usuario-por-id
Servicio: actualizar-email-usuario
Servicio: desactivar-usuario
// → 50 servicios para lo que podría ser un solo módulo de Usuarios

// ✅ Dividir por dominio de negocio completo
Servicio: usuarios       → toda la gestión de usuarios
Servicio: pagos          → toda la lógica de pagos
Servicio: inventario     → toda la gestión de stock
❌ Base de datos compartida entre microservicios
// ❌ Los servicios de Usuarios y Pedidos comparten la misma BD
// Esto es un monolito distribuido, no microservicios reales
// Cualquier cambio de esquema en una tabla afecta a ambos servicios

// ✅ Cada servicio tiene su propia base de datos
// y solo puede acceder a sus propios datos
// Para datos de otro servicio: hace una petición a su API
❌ Ignorar la complejidad operativa
Los microservicios sin las herramientas correctas son un desastre. Necesitas como mínimo: orquestación de contenedores (Kubernetes o similar), trazas distribuidas (Jaeger, Zipkin), métricas centralizadas (Prometheus + Grafana), logs centralizados (ELK stack) y un API Gateway. Sin esto, operar microservicios en producción es inmanejable.
Resumen: lo que aprendiste hoy
- ✅ Un monolito es una aplicación en la que todo el código se despliega como una unidad
- ✅ Los microservicios dividen la aplicación en servicios pequeños, independientes y especializados
- ✅ La comunicación en monolitos es directa (llamadas de función); en microservicios es por red (HTTP o mensajería)
- ✅ El monolito es más simple de desarrollar, desplegar y depurar — ideal para empezar
- ✅ Los microservicios permiten escalar, desplegar y fallar de forma independiente — ideales a gran escala
- ✅ El monolito modular es el término medio: organización de microservicios sin su complejidad operativa
- ✅ Netflix y Amazon migraron a microservicios por necesidad real; Amazon Prime Video volvió al monolito por eficiencia
- ✅ Los patrones clave de microservicios son: API Gateway, Circuit Breaker y Saga
- ✅ No empieces con microservicios: empieza con un monolito y extrae cuando tengas problemas reales
- ✅ Sin DevOps maduro, los microservicios crean más problemas de los que resuelven
🧪 ¿Tienes claros los fundamentos de arquitectura de software?
Los microservicios son una decisión arquitectónica avanzada. Para comprenderlos bien necesitas dominar antes conceptos como qué es una API y cómo funciona, cómo se comunican los sistemas y los fundamentos de diseño de software. Comprueba dónde estás:
👉 Test: Arquitectura de Aplicaciones Web 👉 Test: APIs REST Diseño y Consumo
¿Tu empresa usa monolito o microservicios? ¿Has vivido alguna migración entre arquitecturas? ¿Cuál de los patrones — Circuit Breaker, API Gateway o Saga — te parece más interesante de entender? Cuéntanos en los comentarios 👇 — respondemos todos. 🚀
No hay comentarios todavía. Sé el primero en compartir tu opinión.