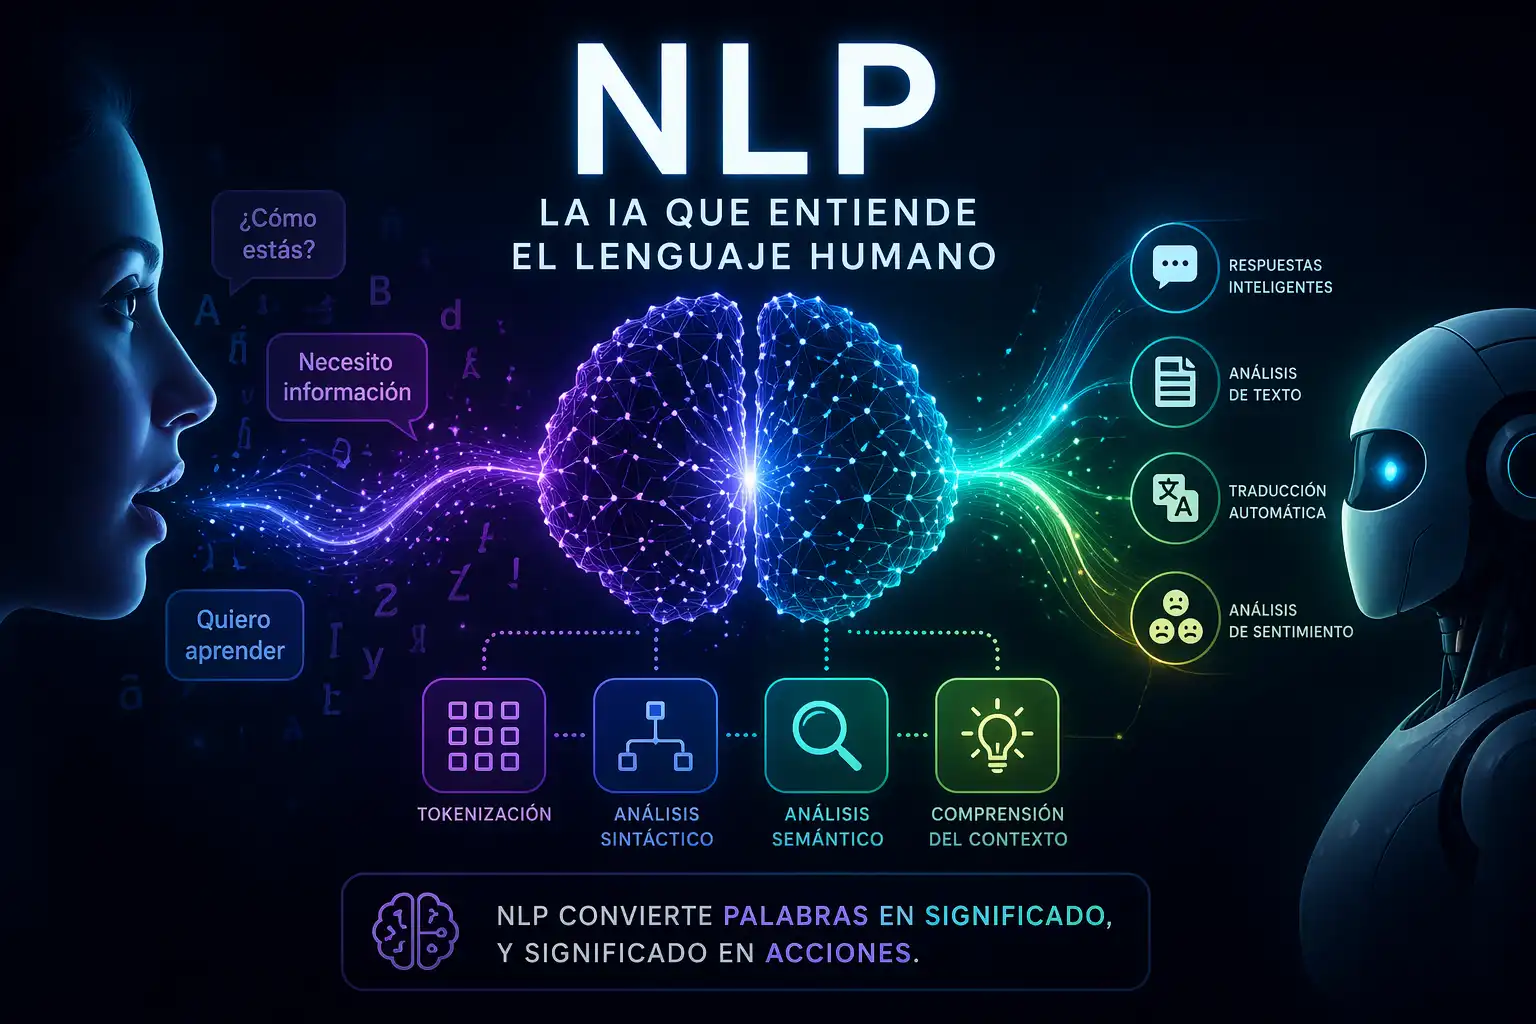
Cuando le escribes un mensaje a ChatGPT y entiende exactamente lo que quieres decir, eso es NLP. Cuando Google completa tu búsqueda antes de que termines de escribirla, eso es NLP. Cuando tu banco analiza automáticamente si una reseña de cliente es positiva o negativa, eso también es NLP.
El Procesamiento de Lenguaje Natural es la rama de la Inteligencia Artificial que permite a las máquinas entender, interpretar y generar lenguaje humano. Y en 2026, está en absolutamente todo.
En este artículo vas a entender qué es, cómo funciona por dentro paso a paso, qué aplicaciones tiene en el mundo real y cómo empezar a usarlo tú mismo con Python.
¿Qué es el Procesamiento de Lenguaje Natural (NLP)?
El Procesamiento de Lenguaje Natural (NLP por sus siglas en inglés: Natural Language Processing, también conocido como PLN en español) es la rama de la Inteligencia Artificial que se ocupa de la interacción entre computadoras y lenguaje humano.
Su objetivo es que las máquinas puedan:
- 📖 Entender lo que los humanos escriben o dicen
- 💬 Interpretar el contexto, la intención y el significado
- ✍️ Generar texto o habla que parezca humano
- 🔄 Traducir entre idiomas con coherencia
NLP combina tres disciplinas: lingüística (cómo funciona el lenguaje), informática (cómo procesarlo eficientemente) e inteligencia artificial (cómo aprender de los datos).
¿Por qué es difícil que las máquinas entiendan el lenguaje humano?
El lenguaje humano es infinitamente complejo. Considera estas frases:
"Vi al hombre con el telescopio"
→ ¿Usé yo el telescopio para ver al hombre?
→ ¿O vi a un hombre que llevaba un telescopio?
Las dos interpretaciones son gramaticalmente correctas.

"El banco estaba lleno"
→ ¿Banco financiero? ¿Banco del parque?
El contexto lo define todo.

"Qué linda está la ciudad"  (irónico en una ciudad contaminada)
→ Literalmente positivo, semánticamente negativo.
Las máquinas no captan la ironía fácilmente.
El lenguaje tiene ambigüedad, metáforas, ironía, modismos, errores ortográficos, abreviaciones, dialectos y un contexto cultural enorme. Enseñarle todo eso a una máquina es el desafío central del NLP.
Breve historia: de las reglas a los transformers
El NLP tiene más de 70 años de historia y ha pasado por tres grandes eras:
Era 1: Basada en reglas (1950s-1980s)
Los primeros sistemas NLP funcionaban con reglas escritas manualmente por lingüistas. "Si la oración contiene X, entonces Y". Funcionaban para casos específicos pero se rompían con cualquier variación inesperada. El primer hito fue el experimento Georgetown-IBM en 1954, que tradujo 60 frases del ruso al inglés.
Era 2: Estadística y Machine Learning (1990s-2010s)
En lugar de reglas manuales, los sistemas aprendían patrones estadísticos de grandes volúmenes de texto. Aquí nacieron el filtrado de spam, la corrección ortográfica moderna y los primeros sistemas de traducción automática. Los modelos aprendían cuán probable era que una palabra siguiera a otra.
Era 3: Deep Learning y Transformers (2017-presente)
En 2017, Google publicó el paper "Attention Is All You Need" que introdujo la arquitectura Transformer. Esto cambió todo. Los transformers pueden entender el contexto de una palabra en relación con todas las demás palabras de una oración simultáneamente, no de forma secuencial. De aquí nacieron BERT (Google, 2018), GPT (OpenAI, 2018) y todos los grandes modelos de lenguaje modernos, incluyendo ChatGPT y Claude.
Cómo funciona el NLP paso a paso
Para entender cómo una máquina procesa una oración, vamos a seguir esta frase de ejemplo por todo el pipeline:
"La empresa Apple anunció pérdidas en el tercer trimestre de 2026"Paso 1: Preprocesamiento del texto
Antes de cualquier análisis, el texto bruto se limpia y prepara.
🔪 Tokenización — dividir en unidades
El texto se divide en tokens (unidades mínimas de análisis). Pueden ser palabras, subpalabras o caracteres.
Texto original:
"La empresa Apple anunció pérdidas en el tercer trimestre de 2026"

Tokenización por palabras:
["La", "empresa", "Apple", "anunció", "pérdidas", "en", "el",
 "tercer", "trimestre", "de", "2026"]

# En Python con NLTK:
from nltk.tokenize import word_tokenize
tokens = word_tokenize("La empresa Apple anunció pérdidas en 2026")
print(tokens)
🗑️ Eliminación de stopwords — quitar palabras vacías
Las stopwords son palabras muy frecuentes que aportan poco significado ("la", "el", "en", "de", "y"). Se eliminan para que el modelo se enfoque en lo importante.
Tokens originales:
["La", "empresa", "Apple", "anunció", "pérdidas", "en", "el",
 "tercer", "trimestre", "de", "2026"]

Después de eliminar stopwords:
["empresa", "Apple", "anunció", "pérdidas", "tercer", "trimestre", "2026"]
🌱 Lematización — reducir a la forma base
Convierte las palabras a su forma raíz. "corriendo" → "correr", "anunció" → "anunciar". Esto permite que el modelo entienda que "corre", "correr" y "corriendo" son la misma raíz.
Antes de lematizar:    "anunció"  "pérdidas"  "tercer"
Después de lematizar:  "anunciar" "pérdida"   "tres"
Paso 2: Análisis lingüístico
🏷️ POS Tagging — etiquetar partes del discurso
Part-Of-Speech Tagging identifica si cada palabra es un sustantivo, verbo, adjetivo, artículo, etc.
La       → DET  (determinante)
empresa  → NOUN (sustantivo)
Apple    → PROPN (nombre propio)
anunció  → VERB (verbo, pasado)
pérdidas → NOUN (sustantivo, plural)
en       → ADP  (preposición)
el       → DET  (determinante)
tercer   → ADJ  (adjetivo ordinal)
trimestre→ NOUN (sustantivo)
de       → ADP  (preposición)
2026     → NUM  (número)
🔗 Análisis de dependencias — relaciones entre palabras
Identifica qué palabras dependen de otras y cómo se conectan para formar el significado.
anunció (verbo principal)
   ├── empresa (sujeto)
   │      └── Apple (modificador — qué empresa)
   └── pérdidas (objeto directo)
          └── tercer trimestre de 2026 (cuándo)
Paso 3: Comprensión semántica
🏢 NER — Reconocimiento de Entidades
Named Entity Recognition identifica entidades nombradas: personas, organizaciones, fechas, lugares, cantidades.
"La empresa Apple anunció pérdidas en el tercer trimestre de 2026"

Entidades detectadas:
  Apple     → ORG  (organización)
  2026      → DATE (fecha/año)
  tercer trimestre → TIME (periodo temporal)
🎭 Análisis de sentimientos
Determina si el texto tiene una connotación positiva, negativa o neutral.
Texto: "La empresa Apple anunció pérdidas en el tercer trimestre de 2026"
Análisis:
  - "pérdidas" → indicador negativo
  - Contexto financiero → relevante para análisis de mercado
  Resultado: NEGATIVO (confianza: 0.87)
Paso 4: Representación numérica — Embeddings
Los algoritmos de Machine Learning no trabajan con texto, trabajan con números. Por eso el texto debe convertirse en vectores numéricos que capturen el significado.
# Word Embeddings: cada palabra se representa como un vector
# de cientos de dimensiones que captura su significado semántico

"rey"    → [0.25, -0.41, 0.78, 0.12, ...]
"reina"  → [0.22, -0.38, 0.75, 0.80, ...]
"hombre" → [0.24, -0.42, 0.23, 0.11, ...]
"mujer"  → [0.21, -0.39, 0.20, 0.79, ...]

# La magia de los embeddings: las relaciones entre palabras
# se preservan matemáticamente:
# "rey" - "hombre" + "mujer" ≈ "reina"
# ¡Las operaciones matemáticas capturan analogías del lenguaje!
Paso 5: El modelo aprende y genera
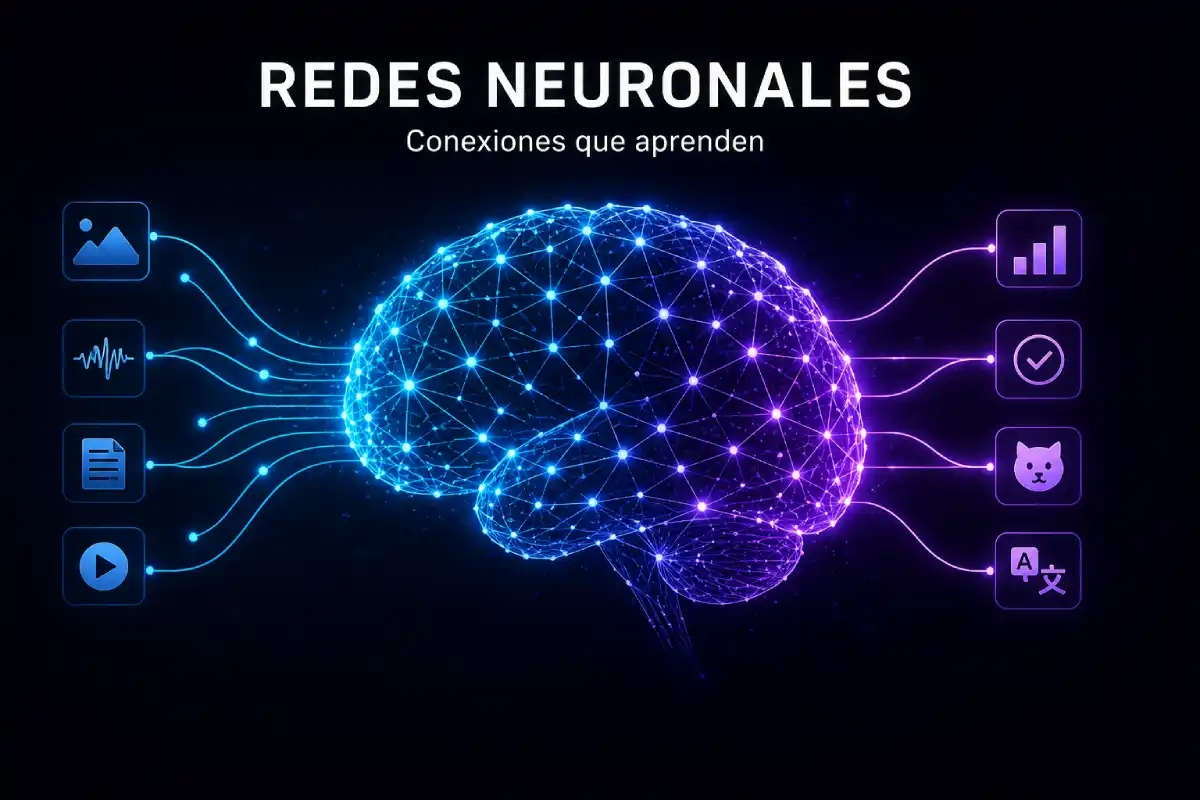
Con los vectores numéricos, el modelo (una red neuronal, generalmente un Transformer) puede aprender patrones del lenguaje y generar predicciones o respuestas.
En los modelos modernos como GPT y Claude, el proceso es: dada una secuencia de tokens anteriores, predecir el token más probable que sigue. Haciendo esto millones de veces con billones de palabras, el modelo "aprende" el idioma.
Las tareas principales del NLP
1. 🌐 Traducción automática
Convertir texto de un idioma a otro manteniendo el significado y el contexto. Google Translate, DeepL y los sistemas de traducción modernos usan arquitecturas Transformer para lograr calidad casi humana en decenas de pares de idiomas.
2. 😊 Análisis de sentimientos
Determinar si un texto expresa una opinión positiva, negativa o neutral. Se usa masivamente para analizar reseñas de productos, comentarios en redes sociales, encuestas de satisfacción y monitoreo de marca.
# Ejemplo con Python
from transformers import pipeline
analizador = pipeline("sentiment-analysis", model="nlptown/bert-base-multilingual-uncased-sentiment")
resultado = analizador("El producto llegó roto y el servicio fue pésimo")
print(resultado)  # [{'label': '1 star', 'score': 0.94}]
3. 🤖 Chatbots y asistentes virtuales
Siri, Alexa, Google Assistant y los chatbots empresariales usan NLP para entender la intención del usuario y generar respuestas relevantes. La diferencia entre un chatbot de árbol de decisiones (rígido) y uno con NLP (flexible) es enorme.
4. 📝 Resumen automático de textos
Condensar documentos largos en resúmenes cortos sin perder las ideas principales. Se usa en derecho para resumir contratos, en medicina para resumir historiales clínicos y en empresas para resumir informes.
5. ❓ Respuesta a preguntas (Question Answering)
Dado un documento y una pregunta, encontrar la respuesta dentro del documento. La base de los motores de búsqueda modernos y de herramientas como ChatGPT al responder sobre documentos específicos.
6. 🏷️ Clasificación de textos
Asignar categorías a textos: spam vs. no spam, idioma del texto, tema del artículo, intención del cliente. El filtro de spam de tu correo lleva usando NLP desde los años 90.
7. 🔤 Corrección ortográfica y gramatical
Detectar y corregir errores de escritura. Las herramientas modernas como Grammarly no solo corrigen ortografía: entienden el contexto para corregir errores gramaticales sutiles.
8. 🔍 Extracción de información
Identificar automáticamente datos estructurados dentro de texto no estructurado: extraer nombres, fechas, precios y relaciones de artículos de noticias, contratos o publicaciones científicas.
Los Transformers: la arquitectura que lo cambió todo
Antes de 2017, los modelos NLP procesaban el texto de forma secuencial: palabra por palabra. El problema es que cuando la oración era larga, el modelo "olvidaba" el contexto del inicio.
Los Transformers revolucionaron esto con el mecanismo de atención: cada palabra puede prestar atención a todas las demás palabras de la oración simultáneamente, independientemente de su distancia.
"El banco donde trabajo está cerca del banco del río"
                ↑                              ↑
           banco=financiero               banco=ribera

# El mecanismo de atención conecta "banco" con "trabajo"
# y con "río" para desambiguar el significado correcto de cada uno.
# Sin atención: el modelo vería dos "banco" idénticos sin contexto.
# Con atención: el modelo entiende que son dos significados diferentes.
Los modelos más importantes basados en Transformers:
- 🟢 BERT (Google, 2018) — bidireccional, lee el texto en ambas direcciones. Excelente para clasificación y respuesta a preguntas
- 🔵 GPT (OpenAI, 2018-presente) — generativo, predice el siguiente token. La base de ChatGPT
- 🟡 T5 (Google, 2019) — convierte todo en una tarea de texto a texto. Muy versátil
- 🟠 RoBERTa (Meta, 2019) — BERT mejorado con más datos de entrenamiento
- 🔴 LLaMA (Meta, 2023-2024) — modelos open source de gran tamaño
NLP con Python: tus primeros pasos
Las dos librerías más populares para NLP en Python son spaCy y NLTK para NLP clásico, y Hugging Face Transformers para modelos modernos.
Con spaCy — rápido y listo para producción
# Instalar
# pip install spacy
# python -m spacy download es_core_news_sm

import spacy

# Cargar el modelo en español
nlp = spacy.load("es_core_news_sm")

# Procesar texto
texto = "Apple anunció pérdidas de 3.000 millones en Madrid el martes."
doc = nlp(texto)

# Tokens y POS tags
print("=== Tokens y etiquetas ===")
for token in doc:
    print(f"{token.text:15} → {token.pos_:6} ({token.dep_})")

# Entidades reconocidas (NER)
print("\n=== Entidades detectadas ===")
for ent in doc.ents:
    print(f"{ent.text:20} → {ent.label_}")

# Salida esperada:
# Apple                → ORG
# 3.000 millones       → MONEY
# Madrid               → LOC
# el martes            → DATE
Con Hugging Face — modelos de última generación
# pip install transformers torch

from transformers import pipeline

# Análisis de sentimientos en español
sentimientos = pipeline(
    "sentiment-analysis",
    model="nlptown/bert-base-multilingual-uncased-sentiment"
)

frases = [
    "El servicio fue excelente, volvería sin duda",
    "Producto muy decepcionante, no lo recomiendo",
    "El envío llegó puntual"
]

for frase in frases:
    resultado = sentimientos(frase)[0]
    print(f"Texto: {frase}")
    print(f"Resultado: {resultado['label']} (confianza: {resultado['score']:.2f})\n")
# Generación de texto con GPT-2
from transformers import pipeline
generador = pipeline("text-generation", model="gpt2")
texto_generado = generador(
"La inteligencia artificial está transformando",
max_length=50,
num_return_sequences=1
)
print(texto_generado[0]['generated_text'])Con NLTK — para aprender los conceptos básicos
# pip install nltk
import nltk
from nltk.tokenize import word_tokenize, sent_tokenize
from nltk.corpus import stopwords
from nltk.stem import SnowballStemmer

nltk.download('punkt')
nltk.download('stopwords')

texto = "Los modelos de NLP han revolucionado la forma en que las máquinas procesan el lenguaje humano."

# Tokenización de oraciones
oraciones = sent_tokenize(texto, language='spanish')
print("Oraciones:", oraciones)

# Tokenización de palabras
palabras = word_tokenize(texto, language='spanish')
print("Palabras:", palabras)

# Eliminar stopwords
stop_words = set(stopwords.words('spanish'))
palabras_limpias = [w for w in palabras if w.lower() not in stop_words]
print("Sin stopwords:", palabras_limpias)

# Stemming (reducir a raíz)
stemmer = SnowballStemmer('spanish')
raices = [stemmer.stem(w) for w in palabras_limpias]
print("Raíces:", raices)
NLP en el mundo real: casos de uso por industria
- 🏥 Medicina — análisis automático de historiales clínicos, extracción de diagnósticos y medicamentos de notas médicas, asistentes para documentación clínica
- ⚖️ Legal — revisión automática de contratos, búsqueda de precedentes judiciales, extracción de cláusulas relevantes en miles de documentos
- 💰 Finanzas — análisis de sentimiento en noticias para predecir movimientos de mercado, detección de fraude en comunicaciones, chatbots de atención al cliente bancaria
- 🛒 E-commerce — análisis de reseñas de productos, clasificación automática de consultas de soporte, recomendaciones basadas en búsquedas en lenguaje natural
- 📱 Redes sociales — moderación automática de contenido, detección de desinformación, análisis de tendencias en tiempo real
- 🎓 Educación — sistemas de tutoría conversacional, corrección automática de ensayos, detección de plagio semántico (no solo literal)
Los retos actuales del NLP
A pesar de todos los avances, el NLP sigue enfrentando desafíos importantes:
- 🌍 Idiomas con pocos recursos — la mayoría de los modelos están entrenados en inglés. Los idiomas con menos presencia digital (lenguas indígenas, dialectos) están infrarrepresentados
- 😏 Ironía y sarcasmo — detectar que "qué gran servicio" es sarcástico en determinado contexto sigue siendo difícil
- 🧠 Razonamiento profundo — los modelos son extraordinarios para reconocer patrones pero aún fallan en razonamiento lógico complejo y matemático
- 🎭 Sesgos — los modelos heredan los sesgos de los textos con los que fueron entrenados
- 💡 Alucinaciones — los modelos generativos pueden producir información falsa con total confianza
Resumen: lo que aprendiste hoy
- ✅ NLP es la rama de la IA que permite a las máquinas entender, interpretar y generar lenguaje humano
- ✅ El lenguaje humano es complejo por su ambigüedad, ironía, metáforas y dependencia del contexto
- ✅ El NLP evolucionó de sistemas basados en reglas → estadística → Deep Learning con Transformers
- ✅ El pipeline de NLP: tokenización → eliminación de stopwords → lematización → POS → NER → embeddings
- ✅ Los embeddings convierten palabras en vectores numéricos que capturan el significado semántico
- ✅ Los Transformers y el mecanismo de atención son la arquitectura detrás de BERT, GPT y Claude
- ✅ Las tareas más comunes son: traducción, análisis de sentimientos, chatbots, clasificación y resumen
- ✅ En Python: spaCy para producción, NLTK para aprender conceptos, Hugging Face para modelos modernos
- ✅ Se aplica en medicina, finanzas, legal, e-commerce, redes sociales y educación
- ✅ Los retos actuales son: idiomas minoritarios, ironía, razonamiento profundo y alucinaciones
🧪 ¿Tienes las bases de Python para empezar con NLP?
Trabajar con NLP en Python requiere dominar los fundamentos del lenguaje: listas, diccionarios, funciones, librerías y manejo de datos. Si durante el artículo te sentiste perdido con alguna parte del código, estos tests son tu próximo paso.
👉 Test: Python Básico 👉 Test: Python Intermedio
¿Ya habías escuchado hablar del NLP antes de este artículo? ¿Cuál aplicación te parece más impactante: el análisis de sentimientos, la traducción automática o los chatbots? ¿Tienes alguna idea de proyecto donde podrías aplicar NLP? Cuéntanos en los comentarios 👇 — respondemos todos. 🚀

No hay comentarios todavía. Sé el primero en compartir tu opinión.