Imagina un equipo de diez desarrolladores trabajando en la misma aplicación. Cada uno escribe código en su propia rama, y cada dos semanas alguien tiene que juntar todo ese trabajo, comprobar que funciona, corregir los conflictos que aparecen, ejecutar cientos de pruebas manualmente y finalmente subir la nueva versión al servidor. El proceso tarda días, es estresante y propenso a errores. A ese proceso se le llamaba, con cierto humor amargo, integration hell.
CI/CD nació para resolver exactamente ese problema. Hoy en día es una práctica estándar en cualquier equipo de desarrollo profesional, y entenderla es fundamental para cualquier desarrollador que quiera trabajar en la industria.
Qué significan CI y CD
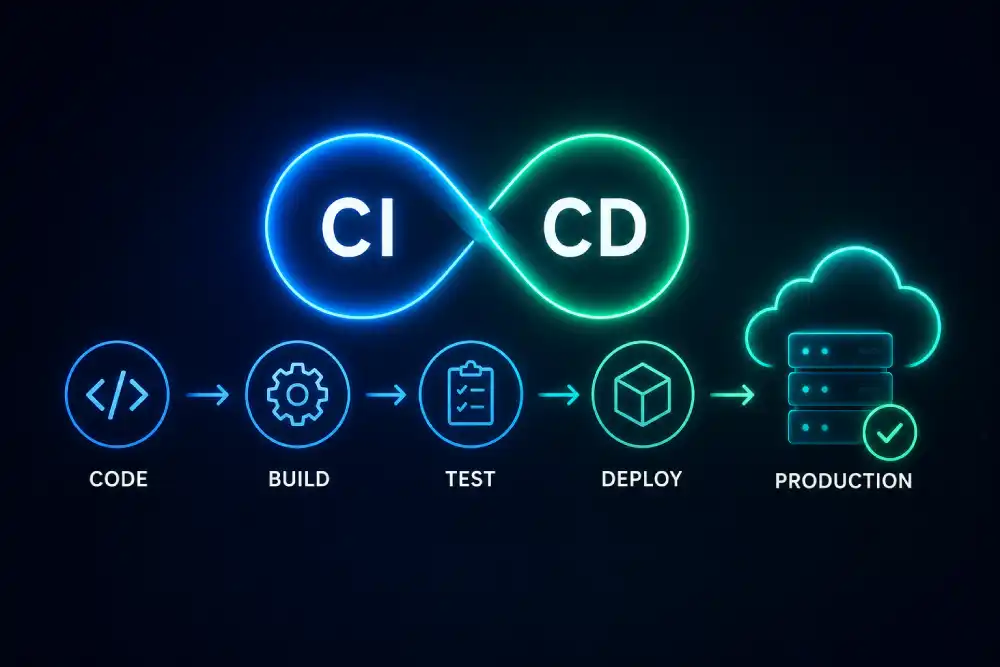
CI/CD son dos conceptos relacionados pero distintos que forman un pipeline (tubería) de automatización desde que el desarrollador escribe código hasta que ese código llega a producción.
- CI — Integración Continua (Continuous Integration): práctica de integrar los cambios de código de todos los desarrolladores en un repositorio compartido varias veces al día, ejecutando de forma automática compilación y pruebas cada vez que alguien hace un commit.
- CD — Entrega Continua (Continuous Delivery): extiende la CI automatizando también la preparación del código para ser desplegado en producción. El despliegue en sí sigue requiriendo aprobación manual.
- CD — Despliegue Continuo (Continuous Deployment): va un paso más allá. Si el código pasa todas las pruebas automáticas, se despliega a producción de forma completamente automática, sin intervención humana.
La distinción entre Entrega Continua y Despliegue Continuo es sutil pero importante. En Entrega Continua hay un botón final que un humano pulsa para mandar el código a producción. En Despliegue Continuo ese botón no existe: si las pruebas pasan, el código llega a los usuarios automáticamente.
El problema que resuelve CI/CD
Antes de CI/CD, los equipos trabajaban con ciclos de integración largos: cada desarrollador trabajaba durante semanas en su rama, y la integración final era un evento doloroso y arriesgado.
Los problemas eran predecibles:
- Conflictos enormes al intentar fusionar ramas que habían divergido durante semanas.
- Bugs que solo aparecían cuando el código de distintos desarrolladores se juntaba.
- Despliegues manuales propensos a errores humanos.
- Ciclos de retroalimentación lentos: un bug introducido el lunes podía no descubrirse hasta el viernes.
- Miedo al despliegue: si cada release es un evento traumático, los equipos despliegan menos, los cambios se acumulan y el riesgo crece.
CI/CD transforma el despliegue de un evento puntual y estresante en un proceso continuo, automatizado y predecible. Empresas como Amazon despliegan a producción miles de veces al día. Netflix, Google y Facebook hacen lo mismo. Eso solo es posible con un pipeline de CI/CD maduro.
Cómo funciona un pipeline de CI/CD
Un pipeline de CI/CD es una secuencia de etapas automatizadas que el código recorre desde que el desarrollador hace un commit hasta que llega a producción. Cada etapa valida el código de alguna forma, y si alguna falla, el pipeline se detiene y notifica al equipo.
Un pipeline típico tiene estas etapas:
1. Commit y trigger
Todo empieza cuando un desarrollador sube código al repositorio. Ese evento (push a una rama, apertura de un pull request, merge a main) dispara el pipeline automáticamente. No hay que hacer nada más: el sistema toma el relevo.
2. Build (compilación)
El primer paso es verificar que el código compila correctamente. En lenguajes compilados como Java o Go esto es obvio. En lenguajes interpretados como Python o JavaScript esta etapa puede incluir la instalación de dependencias, la transpilación (TypeScript a JavaScript) o la generación de artefactos.
# Ejemplo: etapa de build en un proyecto Node.js
- name: Instalar dependencias
  run: npm ci

- name: Compilar TypeScript
  run: npm run build

- name: Verificar que el build fue exitoso
  run: ls -la dist/
3. Pruebas unitarias
Se ejecutan las pruebas más rápidas primero: las pruebas unitarias, que comprueban funciones y módulos de forma aislada. Si alguna prueba falla, el pipeline se detiene aquí y el desarrollador recibe una notificación inmediata.
# Ejemplo: ejecutar pruebas con cobertura
- name: Ejecutar pruebas unitarias
  run: npm test -- --coverage

- name: Verificar cobertura mínima
  run: npm test -- --coverage --coverageThreshold='{"global":{"lines":80}}'
4. Análisis de código (linting y calidad)
Herramientas de análisis estático revisan el código en busca de problemas de estilo, complejidad excesiva, vulnerabilidades de seguridad conocidas o dependencias desactualizadas con vulnerabilidades.
# Análisis de código estático
- name: Ejecutar linter
  run: npm run lint

- name: Verificar vulnerabilidades en dependencias
  run: npm audit --audit-level=high

- name: Análisis de seguridad con SonarQube
  run: sonar-scanner
5. Pruebas de integración
Verifican que los distintos módulos funcionan correctamente juntos, generalmente contra una base de datos real (en un contenedor Docker temporal), APIs externas simuladas o el sistema completo levantado en modo de prueba.
# Levantar servicios necesarios para las pruebas de integración
services:
  postgres:
    image: postgres:15
    env:
      POSTGRES_DB: test_db
      POSTGRES_USER: test
      POSTGRES_PASSWORD: test
    ports:
      - 5432:5432

  redis:
    image: redis:7
    ports:
      - 6379:6379

steps:
  - name: Ejecutar pruebas de integración
    run: npm run test:integration
    env:
      DATABASE_URL: postgresql://test:test@localhost:5432/test_db
      REDIS_URL: redis://localhost:6379
6. Pruebas end-to-end
Simulan el comportamiento real de un usuario interactuando con la aplicación completa desde el navegador. Herramientas como Cypress, Playwright o Selenium automatizan esta etapa. Son las pruebas más lentas y costosas, por lo que se ejecutan al final.
- name: Levantar la aplicación
  run: npm run start:test &

- name: Esperar a que la aplicación esté lista
  run: npx wait-on http://localhost:3000

- name: Ejecutar pruebas E2E con Cypress
  run: npx cypress run --headless
7. Construcción del artefacto
Si todas las pruebas pasan, se construye el artefacto que será desplegado: una imagen Docker, un archivo JAR, un paquete npm, un bundle de una aplicación React, etc.
# Construir y publicar imagen Docker
- name: Construir imagen Docker
  run: docker build -t mi-app:${{ github.sha }} .

- name: Publicar en registro de contenedores
  run: |
    docker tag mi-app:${{ github.sha }} registry.ejemplo.com/mi-app:${{ github.sha }}
    docker push registry.ejemplo.com/mi-app:${{ github.sha }}
8. Despliegue a staging
El artefacto se despliega automáticamente a un entorno de staging (preproducción) que es idéntico al de producción. Aquí el equipo puede hacer pruebas manuales de aceptación antes de dar luz verde al despliegue final.
9. Despliegue a producción
En Entrega Continua, un humano aprueba este paso manualmente. En Despliegue Continuo, ocurre automáticamente si todas las etapas anteriores fueron exitosas.
Herramientas de CI/CD más usadas
GitHub Actions
Integrado directamente en GitHub, es hoy la opción más popular para proyectos que ya usan GitHub. Los pipelines se definen en archivos YAML dentro del repositorio, en la carpeta .github/workflows/.
# .github/workflows/ci.yml
name: Pipeline CI/CD

on:
  push:
    branches: [main, develop]
  pull_request:
    branches: [main]

jobs:
  test:
    runs-on: ubuntu-latest

    steps:
      - name: Clonar el repositorio
        uses: actions/checkout@v4

      - name: Configurar Node.js
        uses: actions/setup-node@v4
        with:
          node-version: '20'
          cache: 'npm'

      - name: Instalar dependencias
        run: npm ci

      - name: Ejecutar linter
        run: npm run lint

      - name: Ejecutar pruebas
        run: npm test

      - name: Construir el proyecto
        run: npm run build

  deploy-staging:
    needs: test
    runs-on: ubuntu-latest
    if: github.ref == 'refs/heads/develop'

    steps:
      - name: Desplegar a staging
        run: echo "Desplegando a staging..."
        # Aquí iría el comando real de despliegue

  deploy-produccion:
    needs: test
    runs-on: ubuntu-latest
    if: github.ref == 'refs/heads/main'
    environment: production   # requiere aprobación manual

    steps:
      - name: Desplegar a producción
        run: echo "Desplegando a producción..."
GitLab CI/CD
GitLab tiene un sistema de CI/CD integrado muy potente, definido en el archivo .gitlab-ci.yml.
# .gitlab-ci.yml
stages:
  - build
  - test
  - deploy

variables:
  DOCKER_IMAGE: registry.gitlab.com/mi-grupo/mi-app

build:
  stage: build
  image: node:20
  script:
    - npm ci
    - npm run build
  artifacts:
    paths:
      - dist/
    expire_in: 1 hour

test:
  stage: test
  image: node:20
  script:
    - npm ci
    - npm test -- --coverage
  coverage: '/Lines\s*:\s*(\d+\.?\d*)%/'

deploy-staging:
  stage: deploy
  script:
    - docker build -t $DOCKER_IMAGE:$CI_COMMIT_SHA .
    - docker push $DOCKER_IMAGE:$CI_COMMIT_SHA
    - kubectl set image deployment/mi-app mi-app=$DOCKER_IMAGE:$CI_COMMIT_SHA
  environment:
    name: staging
    url: https://staging.ejemplo.com
  only:
    - develop

deploy-produccion:
  stage: deploy
  script:
    - kubectl set image deployment/mi-app mi-app=$DOCKER_IMAGE:$CI_COMMIT_SHA
  environment:
    name: production
    url: https://ejemplo.com
  when: manual   # requiere aprobación manual
  only:
    - main
Jenkins
El veterano de las herramientas de CI/CD. Más complejo de configurar que las opciones modernas, pero extremadamente flexible y muy usado en empresas grandes con infraestructura propia.
// Jenkinsfile (pipeline declarativo)
pipeline {
  agent any

  stages {
    stage('Build') {
      steps {
        sh 'npm ci'
        sh 'npm run build'
      }
    }

    stage('Test') {
      steps {
        sh 'npm test'
      }
      post {
        always {
          junit 'test-results/*.xml'
        }
      }
    }

    stage('Docker') {
      steps {
        script {
          def imagen = docker.build("mi-app:${env.BUILD_NUMBER}")
          docker.withRegistry('https://registry.ejemplo.com', 'docker-credentials') {
            imagen.push()
            imagen.push('latest')
          }
        }
      }
    }

    stage('Deploy Staging') {
      when {
        branch 'develop'
      }
      steps {
        sh 'kubectl apply -f k8s/staging/'
      }
    }

    stage('Deploy Producción') {
      when {
        branch 'main'
      }
      input {
        message "¿Desplegar a producción?"
        ok "Sí, desplegar"
      }
      steps {
        sh 'kubectl apply -f k8s/production/'
      }
    }
  }

  post {
    failure {
      mail to: 'equipo@empresa.com',
           subject: "Pipeline fallido: ${env.JOB_NAME}",
           body: "El pipeline falló en: ${env.BUILD_URL}"
    }
  }
}
Otras herramientas populares: CircleCI, Azure DevOps, AWS CodePipeline, Bitbucket Pipelines y Travis CI.
Pipeline completo con GitHub Actions: ejemplo real
Un ejemplo más completo que incluye caché de dependencias, análisis de seguridad, construcción de imagen Docker y despliegue con estrategia de rollback:
# .github/workflows/pipeline-completo.yml
name: Pipeline Completo

on:
  push:
    branches: [main]
  pull_request:
    branches: [main]

env:
  REGISTRY: ghcr.io
  IMAGE_NAME: ${{ github.repository }}

jobs:

  # ── 1. CALIDAD DE CÓDIGO ──────────────────────────────────────
  calidad:
    name: Análisis de código
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4

      - uses: actions/setup-node@v4
        with:
          node-version: '20'
          cache: 'npm'

      - run: npm ci

      - name: Linter
        run: npm run lint

      - name: Verificar tipos (TypeScript)
        run: npm run type-check

      - name: Auditoría de seguridad
        run: npm audit --audit-level=high

  # ── 2. PRUEBAS ────────────────────────────────────────────────
  pruebas:
    name: Pruebas
    runs-on: ubuntu-latest
    needs: calidad

    services:
      postgres:
        image: postgres:15
        env:
          POSTGRES_DB: test
          POSTGRES_USER: test
          POSTGRES_PASSWORD: test
        options: >-
          --health-cmd pg_isready
          --health-interval 10s
          --health-timeout 5s
          --health-retries 5
        ports:
          - 5432:5432

    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-node@v4
        with:
          node-version: '20'
          cache: 'npm'

      - run: npm ci

      - name: Pruebas unitarias
        run: npm run test:unit

      - name: Pruebas de integración
        run: npm run test:integration
        env:
          DATABASE_URL: postgresql://test:test@localhost:5432/test

      - name: Subir reporte de cobertura
        uses: codecov/codecov-action@v4
        with:
          token: ${{ secrets.CODECOV_TOKEN }}

  # ── 3. BUILD DE IMAGEN DOCKER ─────────────────────────────────
  build:
    name: Construir imagen
    runs-on: ubuntu-latest
    needs: pruebas
    if: github.ref == 'refs/heads/main'
    outputs:
      image-tag: ${{ steps.meta.outputs.tags }}

    steps:
      - uses: actions/checkout@v4

      - name: Autenticarse en el registro
        uses: docker/login-action@v3
        with:
          registry: ${{ env.REGISTRY }}
          username: ${{ github.actor }}
          password: ${{ secrets.GITHUB_TOKEN }}

      - name: Metadatos de la imagen
        id: meta
        uses: docker/metadata-action@v5
        with:
          images: ${{ env.REGISTRY }}/${{ env.IMAGE_NAME }}
          tags: |
            type=sha,prefix=,suffix=,format=short
            type=raw,value=latest

      - name: Construir y publicar imagen
        uses: docker/build-push-action@v5
        with:
          context: .
          push: true
          tags: ${{ steps.meta.outputs.tags }}
          cache-from: type=gha
          cache-to: type=gha,mode=max

  # ── 4. DESPLIEGUE A PRODUCCIÓN ────────────────────────────────
  despliegue:
    name: Desplegar a producción
    runs-on: ubuntu-latest
    needs: build
    environment:
      name: production
      url: https://mi-aplicacion.com

    steps:
      - uses: actions/checkout@v4

      - name: Configurar kubectl
        uses: azure/k8s-set-context@v3
        with:
          kubeconfig: ${{ secrets.KUBECONFIG }}

      - name: Desplegar a Kubernetes
        run: |
          kubectl set image deployment/mi-app \
            mi-app=${{ env.REGISTRY }}/${{ env.IMAGE_NAME }}:${{ github.sha }} \
            --record

      - name: Verificar que el despliegue fue exitoso
        run: |
          kubectl rollout status deployment/mi-app --timeout=5m

      - name: Rollback automático si falla
        if: failure()
        run: kubectl rollout undo deployment/mi-app
Estrategias de despliegue
No todos los despliegues son iguales. Según el nivel de riesgo y la necesidad de disponibilidad, existen distintas estrategias.
Blue-Green Deployment
Se mantienen dos entornos idénticos: azul (la versión actual en producción) y verde (la nueva versión). Se despliega en verde, se valida y luego se redirige el tráfico de azul a verde de forma instantánea. Si algo falla, el rollback es inmediato: solo hay que devolver el tráfico al entorno azul.
# Esquema conceptual de Blue-Green
# Estado inicial: tráfico → Blue (v1.0)
# Despliegue: se prepara Green (v2.0) sin afectar tráfico
# Verificación: se valida Green en paralelo
# Switch: tráfico → Green (v2.0)
# Rollback si algo falla: tráfico → Blue (v1.0)
Canary Deployment
Se despliega la nueva versión solo a un pequeño porcentaje de usuarios (el "canario"), se monitoriza el comportamiento y si todo va bien se va aumentando el porcentaje gradualmente hasta llegar al 100%.
# Ejemplo conceptual de Canary con Kubernetes
# Versión actual: 100% del tráfico
# Canary (5%): nueva versión recibe solo el 5% del tráfico
# Si las métricas son correctas, aumentar al 25%, 50%, 100%
# Si algo falla, reducir el canary a 0% inmediatamente
Rolling Deployment
Las instancias de la aplicación se actualizan de una en una (o en pequeños grupos), manteniendo siempre al menos algunas instancias de la versión anterior corriendo durante la transición. Es la estrategia predeterminada de Kubernetes.
# kubernetes: rolling update configuración
spec:
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxSurge: 1        # máximo de pods nuevos al mismo tiempo
      maxUnavailable: 0  # nunca dejar pods fuera de servicio
Buenas prácticas de CI/CD
El pipeline debe ser rápido
Si el pipeline tarda 30 minutos, los desarrolladores dejan de esperar el resultado y siguen trabajando sin saber si rompieron algo. El objetivo es que el feedback llegue en menos de 10 minutos para las etapas críticas. Paraliza las etapas que puedas ejecutar a la vez.
# Ejecutar linting y pruebas en paralelo
jobs:
  lint:
    runs-on: ubuntu-latest
    steps:
      - run: npm run lint

  test:
    runs-on: ubuntu-latest
    steps:
      - run: npm test

  # Este job solo empieza cuando ambos terminan con éxito
  build:
    needs: [lint, test]
    steps:
      - run: npm run build
Falla rápido y falla claro
Ejecuta primero las pruebas más rápidas. Si hay un error de compilación o una prueba unitaria falla, no pierdas tiempo ejecutando las pruebas de integración. El mensaje de error debe indicar exactamente qué falló y por qué.
Los secretos nunca van en el código
Contraseñas, claves API, tokens y certificados deben guardarse en el sistema de gestión de secretos de la plataforma CI/CD (GitHub Secrets, GitLab Variables, Jenkins Credentials), nunca en el código ni en los archivos de configuración del repositorio.
# ❌ Nunca hagas esto
- run: deploy --api-key="sk-abc123secreto"

# ✅ Siempre usa secretos del sistema
- run: deploy --api-key="${{ secrets.API_KEY }}"
El entorno de producción debe ser reproducible
Usa Docker o algún sistema de contenedores para garantizar que lo que pruebas en CI es exactamente lo que llega a producción. La frase "en mi máquina funciona" desaparece cuando el entorno es un contenedor idéntico en todos lados.
Monitoriza después del despliegue
Un pipeline de CI/CD no termina cuando el código llega a producción. Debes monitorizar errores, latencia y comportamiento de la aplicación después de cada despliegue. Si las métricas empeoran, el rollback debe ser automático o al menos rápido.
Mantén el pipeline como código
Los archivos de configuración del pipeline (.github/workflows/, .gitlab-ci.yml, Jenkinsfile) deben vivir en el mismo repositorio que el código. Así se versionan juntos, se revisan en pull requests y cualquier miembro del equipo puede entender y modificar el pipeline.
CI/CD y las ramas de Git
El pipeline de CI/CD se integra directamente con la estrategia de ramas del equipo. Un flujo de trabajo común es:
- Rama de feature: el desarrollador trabaja aquí. Cada push ejecuta lint y pruebas unitarias. Feedback rápido.
- Pull Request a develop: ejecuta el pipeline completo (pruebas unitarias, integración, E2E). Requiere que todo pase antes de poder fusionar.
- Rama develop: despliegue automático a staging tras cada merge.
- Pull Request a main: revisión humana obligatoria. El pipeline completo debe pasar.
- Rama main: despliegue automático o manual con aprobación a producción.
# Ejemplo: pipeline que reacciona diferente según la rama
on:
  push:
    branches: ['**']         # cualquier rama
  pull_request:
    branches: [main, develop]

jobs:
  pruebas-rapidas:
    # Siempre: en cualquier push o PR
    runs-on: ubuntu-latest
    steps:
      - run: npm run lint
      - run: npm run test:unit

  pruebas-completas:
    # Solo en PRs hacia main o develop
    if: github.event_name == 'pull_request'
    runs-on: ubuntu-latest
    steps:
      - run: npm run test:integration
      - run: npm run test:e2e

  despliegue-staging:
    # Solo cuando se fusiona a develop
    if: github.ref == 'refs/heads/develop' && github.event_name == 'push'
    needs: pruebas-rapidas
    steps:
      - run: ./scripts/deploy-staging.sh

  despliegue-produccion:
    # Solo cuando se fusiona a main
    if: github.ref == 'refs/heads/main' && github.event_name == 'push'
    needs: pruebas-rapidas
    environment: production
    steps:
      - run: ./scripts/deploy-produccion.sh
Métricas para medir la madurez de tu CI/CD
El modelo DORA (DevOps Research and Assessment) define cuatro métricas clave para evaluar qué tan bien funciona un pipeline de CI/CD:
- Frecuencia de despliegue: ¿con qué frecuencia se despliega a producción? Los equipos de élite despliegan varias veces al día.
- Lead time for changes: tiempo desde que el desarrollador hace un commit hasta que ese código está en producción. Los mejores equipos lo logran en menos de una hora.
- Change failure rate: porcentaje de despliegues que causan un incidente en producción. Los mejores equipos están por debajo del 5%.
- Time to restore service: tiempo para recuperarse de un fallo en producción. Los mejores equipos lo logran en menos de una hora.
Conclusión
CI/CD no es solo una herramienta técnica. Es un cambio de mentalidad sobre cómo se desarrolla y entrega software. Los equipos que adoptan CI/CD bien implementado despliegan más frecuentemente, con menos errores, con más confianza y con menos estrés.
Empezar no requiere tener todo perfecto desde el primer día. Un pipeline básico que ejecute las pruebas automáticamente en cada commit ya es infinitamente mejor que no tener ninguno. A partir de ahí, puedes ir añadiendo etapas gradualmente: análisis de código, pruebas de integración, despliegue automático a staging, y finalmente a producción.
La inversión en CI/CD se amortiza rápido. Cada bug detectado de forma automática antes de llegar a producción ahorra horas de depuración. Cada despliegue automatizado elimina el riesgo de un error humano. Y cada vez que un desarrollador recibe feedback en minutos en lugar de días, el ritmo del equipo mejora.
Para seguir profundizando en estas prácticas, te recomendamos leer nuestros artículos sobre qué es Docker y para qué sirve y sobre Git y GitHub desde cero, dos herramientas que son la base de cualquier pipeline de CI/CD moderno.

No hay comentarios todavía. Sé el primero en compartir tu opinión.