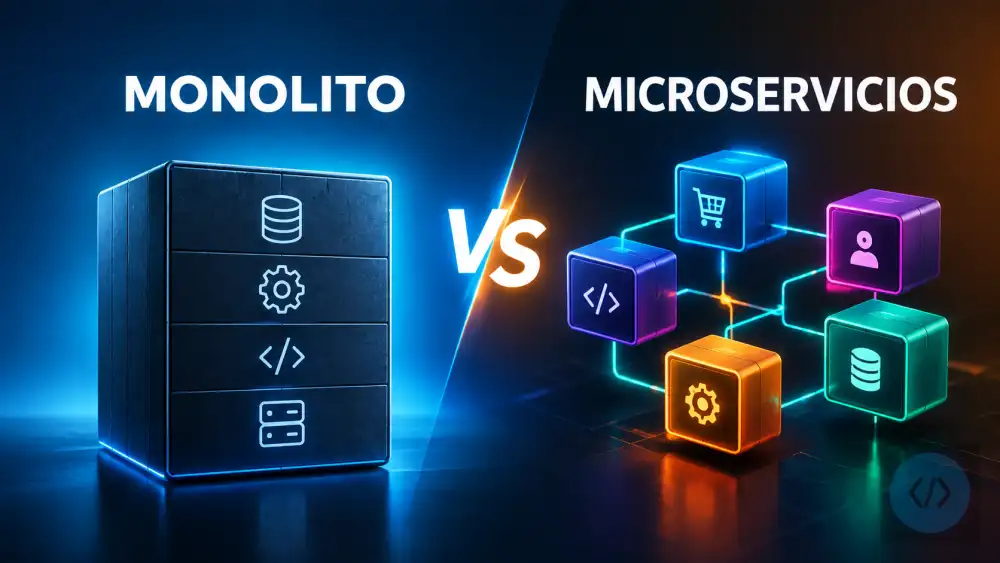
Pocos debates en arquitectura de software generan más opiniones fuertes que microservicios vs monolito. Los defensores de los microservicios hablan de escalabilidad independiente, despliegues autónomos y resiliencia. Los defensores del monolito hablan de simplicidad operacional, depuración directa y menor sobrecarga. La realidad es que ambas arquitecturas tienen contextos donde son la elección correcta, y la confusión surge cuando se aplica una solución sin entender el problema que resuelve.
En esta guía aprenderás qué es cada arquitectura, cuáles son sus ventajas e inconvenientes reales y, sobre todo, cómo decidir cuál conviene en tu situación concreta.
Qué es un monolito
Un monolito es una aplicación donde todos los componentes del sistema se despliegan juntos como una sola unidad. El frontend, el backend, la lógica de negocio, el acceso a datos: todo en el mismo proceso, el mismo repositorio y el mismo despliegue.
# Estructura típica de un monolito bien organizado (modular monolith)

mi-app/
├── src/
│   ├── usuarios/          # módulo de usuarios
│   │   ├── router.py
│   │   ├── servicio.py
│   │   ├── repositorio.py
│   │   └── modelos.py
│   ├── pedidos/           # módulo de pedidos
│   │   ├── router.py
│   │   ├── servicio.py
│   │   ├── repositorio.py
│   │   └── modelos.py
│   ├── pagos/             # módulo de pagos
│   │   ├── router.py
│   │   ├── servicio.py
│   │   └── modelos.py
│   ├── notificaciones/    # módulo de notificaciones
│   └── main.py            # punto de entrada único
├── tests/
├── Dockerfile
└── docker-compose.yml

# Un solo proceso, una sola base de datos, un solo despliegue
# Los módulos se comunican mediante llamadas a funciones directas
# Comunicación entre módulos en un monolito: directa e inmediata

# servicio_pedidos.py
from usuarios.servicio import ServicioUsuarios
from pagos.servicio    import ServicioPagos
from notificaciones.servicio import ServicioNotificaciones

class ServicioPedidos:
    def __init__(self):
        self.usuarios       = ServicioUsuarios()
        self.pagos          = ServicioPagos()
        self.notificaciones = ServicioNotificaciones()

    def crear_pedido(self, usuario_id: int, items: list) -> dict:
        # Llamada directa a función: sin red, sin serialización, sin latencia
        usuario = self.usuarios.obtener_por_id(usuario_id)
        if not usuario.activo:
            raise ValueError("Usuario inactivo no puede crear pedidos")

        total = self.calcular_total(items)

        # Transacción de base de datos que abarca todos los módulos fácilmente
        with db.transaction():
            pedido   = self.repositorio.crear(usuario_id, items, total)
            resultado_pago = self.pagos.cobrar(usuario.metodo_pago, total)
            if not resultado_pago.exitoso:
                raise PaymentError("Pago fallido")
            self.notificaciones.enviar_confirmacion(usuario.email, pedido)

        return pedido
Las ventajas reales del monolito
- Simplicidad operacional: un solo proceso que desplegar, monitorizar y depurar. Los logs están todos en un sitio. Las trazas no cruzan servicios.
- Transacciones ACID sin esfuerzo: como todo comparte la misma base de datos, una operación que afecta a usuarios, pedidos y pagos puede vivir en una sola transacción de base de datos.
- Llamadas a función en lugar de llamadas de red: sin latencia de red, sin serialización/deserialización, sin fallos de conectividad entre servicios.
- Depuración directa: puedes poner un breakpoint y seguir la ejecución a través de todos los módulos en una sola sesión del depurador.
- Refactorización segura: cambiar la firma de una función es un cambio local que el compilador o el IDE detecta inmediatamente.
- Menor overhead de infraestructura: no necesitas service discovery, circuit breakers, API gateways ni sistemas de mensajería distribuida.
Las desventajas del monolito
- Escalado todo-o-nada: si el módulo de generación de informes consume muchos recursos, tienes que escalar toda la aplicación, no solo ese módulo.
- Despliegues acoplados: un cambio pequeño en cualquier módulo requiere desplegar toda la aplicación, lo que aumenta el riesgo y la frecuencia de los despliegues.
- El big ball of mud: sin disciplina, las dependencias entre módulos se multiplican hasta que tocar cualquier cosa puede romper cualquier otra cosa. El monolito deja de estar organizado y se convierte en una maraña.
- Un único stack tecnológico: todos los módulos deben usar el mismo lenguaje y las mismas librerías. No puedes elegir Python para el módulo de ML y Go para el de alto rendimiento.
Qué son los microservicios
Los microservicios dividen la aplicación en servicios pequeños e independientes, cada uno con su propia base de datos, su propio proceso y su propio despliegue. Los servicios se comunican entre sí a través de la red, normalmente mediante APIs REST, gRPC o mensajería asíncrona.
# Arquitectura de microservicios para la misma tienda

# Cada servicio es un repositorio, un proceso y un despliegue independiente

servicio-usuarios/          # equipo A
├── src/
├── Dockerfile
└── bd: PostgreSQL propia

servicio-pedidos/           # equipo B
├── src/
├── Dockerfile
└── bd: PostgreSQL propia

servicio-pagos/             # equipo C (puede usar tecnología diferente)
├── src/                    # quizás en Go para rendimiento
├── Dockerfile
└── bd: PostgreSQL propia

servicio-notificaciones/    # equipo D
├── src/
├── Dockerfile
└── sin bd: solo envía emails/SMS

api-gateway/                # punto de entrada único para los clientes
├── src/
└── Dockerfile

cola-mensajes/              # comunicación asíncrona entre servicios
└── RabbitMQ o Kafka
# Comunicación entre microservicios: a través de la red

# servicio-pedidos/src/servicio.py
import httpx
import json
from typing import Optional

class ServicioPedidos:
    def __init__(self):
        self.url_usuarios       = "http://servicio-usuarios:8001"
        self.url_pagos          = "http://servicio-pagos:8002"
        self.cola_notificaciones = ColaRabbitMQ("notificaciones")

    async def crear_pedido(self, usuario_id: int, items: list) -> dict:
        # Llamada HTTP al servicio de usuarios
        async with httpx.AsyncClient() as client:
            respuesta = await client.get(f"{self.url_usuarios}/usuarios/{usuario_id}")

        if respuesta.status_code == 404:
            raise ValueError("Usuario no encontrado")

        usuario = respuesta.json()

        # Calcular total localmente
        total = self.calcular_total(items)

        # Guardar pedido en la BD propia del servicio de pedidos
        pedido = await self.repositorio.crear(usuario_id, items, total)

        # Llamada HTTP al servicio de pagos
        async with httpx.AsyncClient() as client:
            respuesta_pago = await client.post(
                f"{self.url_pagos}/cobrar",
                json={"usuario_id": usuario_id, "total": total}
            )

        if not respuesta_pago.json()["exitoso"]:
            # ¿Qué pasa con el pedido que ya creamos? → Saga pattern
            await self.repositorio.marcar_fallido(pedido["id"])
            raise PaymentError("Pago fallido")

        # Notificación asíncrona: el servicio de pedidos no espera la respuesta
        await self.cola_notificaciones.publicar({
            "tipo":    "pedido_confirmado",
            "email":   usuario["email"],
            "pedido":  pedido
        })

        return pedido
Las ventajas reales de los microservicios
- Escalado independiente: si el servicio de búsqueda recibe 100 veces más tráfico que el de usuarios, puedes escalar solo ese servicio.
- Despliegues independientes: el equipo de pagos puede desplegar su servicio sin coordinar con el equipo de usuarios ni detener la aplicación completa.
- Aislamiento de fallos: si el servicio de recomendaciones cae, los pedidos siguen funcionando.
- Autonomía de los equipos: cada equipo es propietario de su servicio, puede elegir su stack tecnológico y despliega cuando está listo.
- Flexibilidad tecnológica: el servicio de procesamiento de imágenes puede usar Python con PyTorch, el API gateway puede estar en Go y el servicio de notificaciones en Node.js.
Las desventajas reales de los microservicios
- Complejidad operacional: docenas de servicios que desplegar, monitorizar y mantener. Necesitas Kubernetes o equivalente, service discovery, API gateway, distributed tracing, alertas por servicio.
- Consistencia eventual y transacciones distribuidas: mantener la consistencia entre bases de datos de distintos servicios es un problema complejo que requiere patrones como Saga o Two-Phase Commit.
- Latencia de red acumulada: una petición del usuario puede pasar por 5 servicios en cadena, acumulando latencia en cada salto.
- Depuración distribuida: un error en una petición puede originarse en el cuarto servicio de una cadena. Sin distributed tracing (Jaeger, Zipkin), encontrarlo es muy difícil.
- Testing de integración complejo: testear que el servicio de pedidos funciona correctamente con el de pagos y el de usuarios requiere levantar todos esos servicios o mockearlos.
- Overhead de comunicación: serializar y deserializar JSON, establecer conexiones HTTP, manejar timeouts y reintentos para lo que en un monolito es una llamada a función.
La trampa más habitual: empezar con microservicios
El error más común que cometen los equipos es empezar un proyecto nuevo directamente con microservicios porque "escala mejor" o porque es lo que usan las grandes empresas. Lo que olvidan es que Amazon, Netflix y Uber empezaron con monolitos y migraron a microservicios cuando el crecimiento lo justificó, con centenares de ingenieros gestionando la complejidad.
# La realidad del "microservicio prematuro"

# Semana 1: el equipo de 3 personas decide hacer microservicios
# porque "quieren hacerlo bien desde el principio"

# Lo que pasan el primer mes:
# - Configurar Kubernetes en lugar de escribir lógica de negocio
# - Decidir cómo comunicar los servicios (HTTP? gRPC? RabbitMQ?)
# - Implementar autenticación en cada servicio por separado
# - Configurar distributed tracing para depurar
# - Gestionar la consistencia entre bases de datos
# - Escribir el triple de código de boilerplate

# Lo que debería hacer ese equipo:
# - Un monolito bien modularizado
# - Foco en el producto y la validación del negocio
# - Separar en servicios cuando un módulo concreto tenga un problema
#   de escala o de autonomía de equipo que no se pueda resolver de otra forma

# Martin Fowler lo llamó "monolith first":
# "Don't start a new project with microservices,
#  even if you're sure your application will be big enough to make it worthwhile."
El monolito modular: lo mejor de ambos mundos
Entre el monolito sin estructura y los microservicios hay una opción intermedia que es la más adecuada para la mayoría de proyectos: el monolito modular. Un solo despliegue, pero con módulos bien delimitados que tienen sus propias interfaces claras y no dependen directamente de los internos de otros módulos.
# Monolito modular: módulos con interfaces bien definidas

# En lugar de que el servicio de pedidos llame directamente
# a la función interna del repositorio de usuarios:

# ❌ Acoplamiento directo (anti-patrón en monolito mal organizado)
from usuarios.repositorio import UsuarioRepository
repo = UsuarioRepository()
usuario = repo.db.query("SELECT * FROM usuarios WHERE id = ?", [id])

# ✅ Interfaz pública del módulo (monolito modular)
from usuarios import obtener_usuario_por_id
# El módulo de pedidos solo conoce la interfaz pública del módulo de usuarios
usuario = obtener_usuario_por_id(id)

# usuarios/__init__.py — interfaz pública del módulo
from .servicio import ServicioUsuarios

_servicio = ServicioUsuarios()

def obtener_usuario_por_id(id: int) -> dict:
    return _servicio.obtener_por_id(id)

def usuario_existe(id: int) -> bool:
    return _servicio.existe(id)

# Los internos del módulo (repositorio, modelos, queries SQL)
# son privados: otros módulos no pueden importarlos directamente
# Ventaja del monolito modular:
# Cuando necesites extraer un módulo a microservicio,
# ya tienes la interfaz definida.
# Solo cambias cómo se llama (de función a HTTP)
# sin cambiar qué se llama.

# Antes (monolito modular):
from usuarios import obtener_usuario_por_id
usuario = obtener_usuario_por_id(123)

# Después (microservicio extraído):
# Crear un cliente HTTP con la misma interfaz
import httpx

def obtener_usuario_por_id(id: int) -> dict:
    respuesta = httpx.get(f"http://servicio-usuarios/usuarios/{id}")
    return respuesta.json()

# El código de pedidos no cambia: solo cambia la implementación de la función
Cuándo los microservicios sí tienen sentido
Los microservicios resuelven problemas reales cuando aparecen ciertas condiciones. Si no tienes estas condiciones, probablemente no los necesitas.
# Señal 1: equipos grandes que pisan sobre el mismo código
# Si tienes 50 desarrolladores trabajando en el mismo repositorio,
# los conflictos de merge, los despliegues coordinados y las dependencias
# entre equipos generan tanto fricción que tiene sentido separar en servicios
# que cada equipo controla de forma autónoma.

# Señal 2: módulos con necesidades de escala muy diferentes
# Si el servicio de vídeo necesita 100x más recursos que el resto,
# escalar todo el monolito es muy caro.
# Separar ese módulo permite escalarlo independientemente.

# Señal 3: necesidades tecnológicas distintas por dominio
# El módulo de ML necesita Python con PyTorch y GPU.
# El módulo de API necesita Go para alta concurrencia.
# El módulo de procesamiento de datos necesita Scala con Spark.
# En un monolito, esto es imposible o muy difícil.

# Señal 4: ciclos de despliegue que se bloquean entre equipos
# Si el equipo de pagos tiene listo su feature pero no puede desplegar
# porque el equipo de catálogo tiene un bug en el mismo monolito,
# los microservicios dan autonomía de despliegue.

# Señal 5: requisitos de resiliencia muy diferentes
# Si el módulo de recomendaciones puede caer sin afectar a los pedidos,
# aislarlo como servicio protege el core del negocio de sus fallos.
Patrones de transición: del monolito al microservicio
# Patrón Strangler Fig: extraer servicios de forma incremental
# (como la higuera estranguladora que crece alrededor del árbol huésped)

# Paso 1: el monolito maneja todo
# Paso 2: añadir un API Gateway delante del monolito
# Paso 3: extraer el módulo más candidato como microservicio
# Paso 4: el API Gateway redirige las rutas del módulo extraído al nuevo servicio
# Paso 5: el monolito ya no gestiona esas rutas
# Repetir con el siguiente módulo

# Ejemplo con nginx como API Gateway:
# nginx.conf

# /api/pagos → servicio de pagos (ya extraído)
location /api/pagos {
    proxy_pass http://servicio-pagos:8002;
}

# Todo lo demás → monolito (aún no extraído)
location /api/ {
    proxy_pass http://monolito:8000;
}

# Ventaja: la transición es gradual y reversible
# El monolito sigue funcionando mientras extraes módulo a módulo
# Patrón de bases de datos compartidas → separadas
# Uno de los pasos más difíciles de la migración

# Fase 1: misma BD, módulos lógicamente separados en el código
# Todos los servicios usan la misma BD de PostgreSQL
# Cada módulo tiene su propio schema: usuarios.*, pedidos.*, pagos.*

# Fase 2: separar los schemas en BDs distintas
# Cada servicio solo puede leer/escribir su propio schema
# Los joins entre tablas de distintos schemas ya no están permitidos
# Hay que reemplazarlos con llamadas HTTP entre servicios

# Fase 3: mover cada schema a su propio servidor de BD

# Este proceso tarda meses y requiere eliminar todos los joins entre dominios
# Es el mayor trabajo técnico de una migración a microservicios
Guía de decisión: qué elegir
| Situación | Arquitectura recomendada |
|---|---|
| Startup validando un producto nuevo | Monolito |
| Equipo de menos de 10 desarrolladores | Monolito |
| Dominio del problema no está claro todavía | Monolito (es más fácil refactorizar) |
| Presupuesto de infraestructura limitado | Monolito |
| Monolito que empieza a tener problemas reales de escala | Monolito modular → extraer servicios gradualmente |
| Equipos grandes con autonomía de despliegue necesaria | Microservicios |
| Módulos con necesidades de escala o tecnología muy diferentes | Extraer solo esos módulos como microservicios |
| Empresa con plataforma de datos establecida y DevOps maduro | Microservicios |
Resumen
- Un monolito despliega toda la aplicación como una sola unidad. Sus ventajas son simplicidad operacional, transacciones ACID sin esfuerzo, depuración directa y menor overhead de infraestructura. Sus problemas son el escalado todo-o-nada, los despliegues acoplados y el riesgo de convertirse en una maraña de dependencias sin disciplina.
- Los microservicios dividen la aplicación en servicios independientes con sus propias bases de datos. Sus ventajas son el escalado y despliegue independientes, el aislamiento de fallos y la autonomía de los equipos. Sus problemas son la complejidad operacional, las transacciones distribuidas, la latencia acumulada y la dificultad de depuración.
- El error más habitual es empezar con microservicios sin tener los problemas que resuelven. Los equipos grandes que los usan con éxito (Amazon, Netflix) tienen centenares de ingenieros gestionando esa complejidad.
- El monolito modular es la opción más adecuada para la mayoría de proyectos: un solo despliegue con módulos bien delimitados e interfaces públicas claras. Cuando un módulo necesite extraerse como servicio, la interfaz ya está definida.
- La estrategia correcta es monolith first: empezar con un monolito bien estructurado y extraer servicios de forma incremental (patrón Strangler Fig) cuando aparezcan problemas reales de escala, autonomía de equipo o tecnología.
HTMLEOF Salida exit code 0
No hay comentarios todavía. Sé el primero en compartir tu opinión.