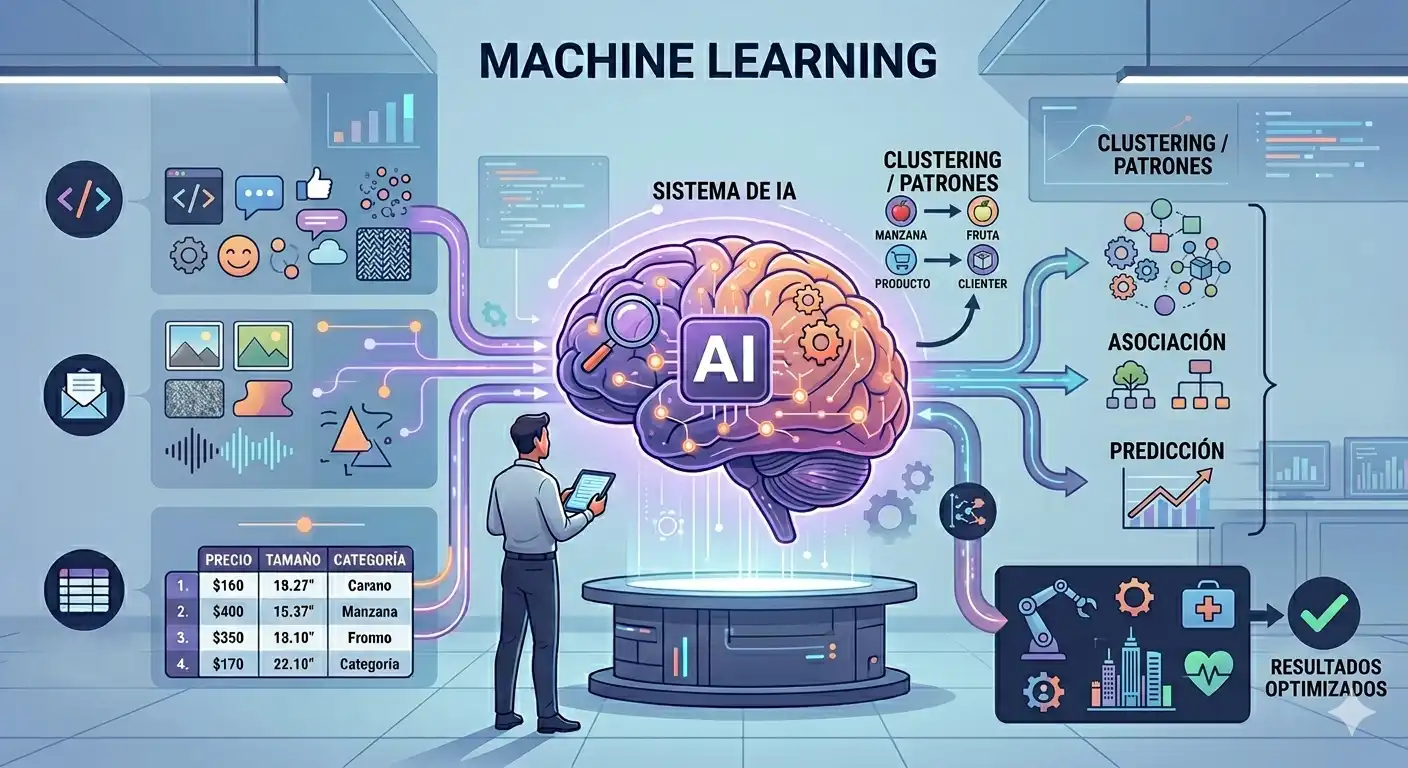
Cuando hablas de Machine Learning, tarde o temprano aparece la pregunta: ¿supervisado o no supervisado? Son los dos grandes enfoques del aprendizaje automático y elegir el correcto para cada problema marca la diferencia entre un modelo útil y uno que no sirve para nada.
La buena noticia es que la diferencia fundamental es más sencilla de entender de lo que parece. Y una vez que la tienes clara, todo lo demás encaja.
En este artículo vas a entender qué es cada enfoque, en qué se diferencian, qué algoritmos incluye cada uno, cuándo usar cada uno y cómo se ven en código Python real.
La diferencia fundamental en una frase
Antes de entrar en detalles técnicos, quédate con esta idea:
- 🏷️ Supervisado — aprendes con datos que tienen respuestas correctas. El maestro está presente.
- 🔍 No supervisado — aprendes de datos sin respuestas correctas. Descubres patrones por tu cuenta.
La analogía perfecta:
Imagina que quieres aprender a distinguir frutas. Con aprendizaje supervisado es como tener un profesor que te muestra miles de fotos y te dice "esto es una manzana, esto es una naranja, esto es un plátano". Aprendes la relación entre la imagen y su nombre correcto.
Con aprendizaje no supervisado es como recibir una caja con mil frutas mezcladas y ordenarlas por tu cuenta: sin saber los nombres, las agrupas por color, forma y textura. Quizás acabas con 4 grupos distintos sin saber exactamente qué es cada uno, pero has descubierto que tienen características en común.
Machine Learning Supervisado — aprender con respuestas

¿Cómo funciona?
En el aprendizaje supervisado el modelo recibe un conjunto de datos de entrenamiento con dos partes:
- X — las características de entrada (los datos que describe cada ejemplo)
- y — la etiqueta o respuesta correcta para cada ejemplo
El modelo aprende a mapear X → y. Una vez entrenado, puede predecir y para nuevos datos X que nunca ha visto.
# Datos de entrenamiento supervisado
# X = características del email, y = es spam o no

X = [
  ["oferta exclusiva", "haz clic", "gana dinero"],   # y = 1 (spam)
  ["reunión mañana", "adjunto informe", "proyecto"],  # y = 0 (no spam)
  ["premio millonario", "reclamalo ya", "gratis"],    # y = 1 (spam)
  ["actualización sistema", "ticket soporte"],        # y = 0 (no spam)
]
y = [1, 0, 1, 0]

# El modelo aprende: si el email tiene estas palabras → probablemente spam
# Luego predice: nuevo_email → ¿1 (spam) o 0 (no spam)?
Los dos tipos de problemas supervisados
📦 Clasificación — predecir una categoría
La salida es una clase discreta: sí/no, tipo A/B/C, categoría 1/2/3.
# Ejemplos de clasificación

# Binaria (2 clases):
"¿Este tumor es maligno o benigno?"           → maligno / benigno
"¿Este email es spam?"                         → spam / no spam
"¿El cliente va a cancelar la suscripción?"    → sí / no

# Multiclase (más de 2 clases):
"¿Qué dígito escrito a mano es este?"         → 0, 1, 2, ..., 9
"¿En qué categoría va este artículo?"         → deportes / política / tech
"¿Qué tipo de flor es esta?"                  → setosa / versicolor / virginica
📈 Regresión — predecir un número continuo
La salida es un valor numérico que puede tomar cualquier valor dentro de un rango.
# Ejemplos de regresión

"¿Cuánto costará esta casa?"                  → 245,000 €
"¿Qué temperatura habrá mañana?"              → 23.4 °C
"¿Cuántas unidades venderemos este mes?"      → 1,847 unidades
"¿Cuánto tiempo tardará en llegar el pedido?" → 3.2 días
Algoritmos supervisados más importantes
| Algoritmo | Tipo | ¿Cuándo usarlo? | Ejemplo real |
|---|---|---|---|
| Regresión Logística | Clasificación | Clasificación binaria simple e interpretable | Detección de spam, aprobado/suspenso |
| Regresión Lineal | Regresión | Relaciones lineales entre variables | Precio de casas, ventas futuras |
| Árbol de Decisión | Ambos | Cuando necesitas interpretabilidad total | Diagnóstico médico, aprobación de crédito |
| Random Forest | Ambos | Alta precisión en datos tabulares | Detección de fraude bancario |
| SVM | Ambos | Datos de alta dimensionalidad, textos | Clasificación de documentos |
| KNN | Ambos | Datasets pequeños, recomendaciones simples | Sistema de recomendación básico |
| XGBoost / LightGBM | Ambos | Máxima precisión en competencias y producción | Predicción de churn, precios de vuelos |
| Redes Neuronales | Ambos | Imágenes, texto, audio, problemas complejos | Reconocimiento facial, diagnóstico por imagen |
Ejemplo en Python: clasificación supervisada
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report

# 1. Cargar datos etiquetados
# El dataset Iris tiene flores con etiquetas: 0=setosa, 1=versicolor, 2=virginica
iris = load_iris()
X = iris.data    # características: longitud/ancho de pétalos y sépalos
y = iris.target  # etiquetas: tipo de flor (la respuesta correcta)

# 2. Dividir en entrenamiento y prueba
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

print(f"Entrenamiento: {len(X_train)} muestras con etiquetas")
print(f"Prueba: {len(X_test)} muestras (para evaluar)")

# 3. Entrenar el modelo supervisado
modelo = RandomForestClassifier(n_estimators=100, random_state=42)
modelo.fit(X_train, y_train)  # aprende X → y

# 4. Predecir con datos nuevos
predicciones = modelo.predict(X_test)

# 5. Evaluar (podemos medir precisión porque tenemos y_test para comparar)
print(classification_report(y_test, predicciones,
      target_names=iris.target_names))

# Resultado típico: ~97% de precisión
💡 Clave del supervisado: podemos medir la precisión del modelo porque tenemos las respuestas correctas (y_test) para comparar con las predicciones.
Machine Learning No Supervisado — descubrir sin respuestas

¿Cómo funciona?
En el aprendizaje no supervisado el modelo solo recibe X. No hay etiquetas, no hay respuestas correctas, no hay un maestro que corrija. El algoritmo tiene que descubrir por sí solo la estructura, los patrones y las relaciones que existen en los datos.
# Datos NO supervisados — solo características, sin etiquetas

clientes = [
  {"edad": 25, "compras_mes": 15, "ticket_promedio": 45},
  {"edad": 52, "compras_mes": 3,  "ticket_promedio": 320},
  {"edad": 28, "compras_mes": 12, "ticket_promedio": 55},
  {"edad": 48, "compras_mes": 2,  "ticket_promedio": 480},
  {"edad": 31, "compras_mes": 18, "ticket_promedio": 38},
]
# No sabemos a qué grupo pertenece cada cliente
# El algoritmo debe descubrir si hay grupos naturales
Los tres tipos de problemas no supervisados
🗂️ Clustering (Agrupamiento) — encontrar grupos naturales
El algoritmo agrupa los datos en clusters basándose en similitudes, sin conocer de antemano cuántos grupos hay ni cuáles son.
# Ejemplos de clustering

"¿Qué tipos de clientes tiene nuestra tienda?"
→ Descubre: jóvenes compradores frecuentes, compradores premium esporádicos, etc.

"¿Qué genes se expresan de forma similar?"
→ Agrupa genes con comportamiento parecido para entender enfermedades

"¿Qué artículos de noticias hablan de lo mismo?"
→ Google Noticias usa clustering para agrupar artículos sobre el mismo evento
📐 Reducción de dimensionalidad — simplificar sin perder información
Reduce el número de variables (dimensiones) de los datos manteniendo la mayor cantidad de información relevante posible.
# Ejemplos de reducción de dimensionalidad

Dataset original: imagen de 28×28 píxeles = 784 variables
Después de PCA:   solo 50 componentes que capturan el 95% de la info
→ El modelo aprende más rápido y con menos ruido

Dataset de texto: 10,000 palabras únicas = 10,000 variables
Después de reducción: 300 dimensiones (word embeddings)
→ Las palabras similares quedan cerca en el espacio reducido
🔗 Reglas de asociación — encontrar relaciones entre elementos
Descubre qué elementos tienden a aparecer juntos en los datos.
# El ejemplo clásico: análisis de la cesta de la compra

Datos: millones de tickets de compra sin etiquetas
El algoritmo descubre:
  "El 73% de quienes compran pañales también compran cerveza"
  "Los compradores de pasta también compran tomate (confianza: 81%)"
  "Los viernes por la tarde los clientes compran snacks + bebidas"

→ Amazon usa esto para "También te puede interesar..."
→ Los supermercados para organizar los pasillos estratégicamente
Algoritmos no supervisados más importantes
| Algoritmo | Tipo | ¿Cuándo usarlo? | Ejemplo real |
|---|---|---|---|
| K-Means | Clustering | Segmentación cuando sabes cuántos grupos quieres | Segmentación de clientes, compresión de imágenes |
| DBSCAN | Clustering | Detección de anomalías, grupos de forma irregular | Detección de fraude, análisis geoespacial |
| Clustering jerárquico | Clustering | Cuando quieres explorar la estructura sin fijar grupos | Taxonomía biológica, análisis de genes |
| PCA | Reducción | Reducir dimensiones linealmente, visualización | Compresión de imágenes, preprocesamiento |
| t-SNE / UMAP | Reducción | Visualización de datos de alta dimensionalidad | Visualizar embeddings de texto o imágenes |
| Apriori / FP-Growth | Asociación | Encontrar patrones en transacciones | Análisis de cesta de la compra, cross-selling |
| Autoencoders | Ambos | Detección de anomalías, generación de datos | Detección de fraude, compresión de datos |
Ejemplo en Python: clustering no supervisado
import numpy as np
import matplotlib.pyplot as plt
from sklearn.cluster import KMeans
from sklearn.preprocessing import StandardScaler

# 1. Datos SIN etiquetas — solo características de clientes
np.random.seed(42)
n = 200

# Simulamos 3 tipos de clientes (pero el modelo no lo sabe)
clientes = np.vstack([
    np.random.normal([25, 15, 45],  [3, 3, 10], (n//3, 3)),  # jóvenes frecuentes
    np.random.normal([50, 3, 350],  [5, 1, 50], (n//3, 3)),  # premium esporádicos
    np.random.normal([35, 8, 120],  [4, 2, 20], (n//3, 3)),  # intermedios
])
# Columnas: [edad, compras_mes, ticket_promedio]
# ¡Sin etiquetas! El modelo debe descubrir los grupos

# 2. Normalizar (muy importante en clustering)
scaler = StandardScaler()
X_scaled = scaler.fit_transform(clientes)

# 3. Aplicar K-Means (elegimos 3 grupos)
kmeans = KMeans(n_clusters=3, random_state=42, n_init=10)
etiquetas_descubiertas = kmeans.fit_predict(X_scaled)

# 4. Interpretar los grupos descubiertos
print("Grupos descubiertos por el modelo:")
for grupo in range(3):
    mask = etiquetas_descubiertas == grupo
    datos_grupo = clientes[mask]
    print(f"\n  Grupo {grupo} ({mask.sum()} clientes):")
    print(f"    Edad promedio:         {datos_grupo[:,0].mean():.1f} años")
    print(f"    Compras/mes promedio:  {datos_grupo[:,1].mean():.1f}")
    print(f"    Ticket promedio:       ${datos_grupo[:,2].mean():.0f}")

# Salida aproximada:
# Grupo 0 (67 clientes): Edad: 24.8 años, Compras: 15.1, Ticket: $44
# → Jóvenes compradores frecuentes de bajo ticket
# Grupo 1 (66 clientes): Edad: 49.8 años, Compras: 3.0, Ticket: $350
# → Clientes premium que compran poco pero mucho
# Grupo 2 (67 clientes): Edad: 35.1 años, Compras: 8.0, Ticket: $120
# → Segmento intermedio

# ⚠️ El modelo no sabe los nombres — los humanos los interpretamos
💡 Clave del no supervisado: no podemos medir la "precisión" de la misma forma que en supervisado porque no tenemos etiquetas correctas con qué comparar. La evaluación es más cualitativa: ¿tienen sentido los grupos encontrados?
La diferencia clave visualizada
============================================================
SUPERVISADO — El maestro está presente
============================================================

Datos de entrenamiento:
  Email 1 → palabras: [oferta, gratis, clic]  → SPAM    ← etiqueta
  Email 2 → palabras: [reunión, informe, hoy] → NO SPAM ← etiqueta
  Email 3 → palabras: [gana, dinero, fácil]   → SPAM    ← etiqueta

El modelo aprende: patrón de palabras → tipo de email

Datos nuevos:
  Email X → palabras: [premio, gratis, ahora]  → modelo predice: SPAM ✅
  Email Y → palabras: [proyecto, cliente, doc] → modelo predice: NO SPAM ✅

============================================================
NO SUPERVISADO — El explorador sin mapa
============================================================

Datos de entrenamiento:
  Email 1 → palabras: [oferta, gratis, clic]  → ??? (sin etiqueta)
  Email 2 → palabras: [reunión, informe, hoy] → ??? (sin etiqueta)
  Email 3 → palabras: [gana, dinero, fácil]   → ??? (sin etiqueta)

El modelo descubre: hay 2 grupos naturales de emails
  Grupo A: emails con palabras [oferta, gratis, dinero, clic]
  Grupo B: emails con palabras [reunión, proyecto, informe, cliente]

Un humano interpreta: Grupo A = spam, Grupo B = trabajo
(¡pero el modelo solo encontró la estructura!)
Tabla comparativa completa
| Característica | 🏷️ Supervisado | 🔍 No Supervisado |
|---|---|---|
| Datos de entrenamiento | Etiquetados (X + y) | Sin etiquetar (solo X) |
| Intervención humana | Alta — alguien etiqueta los datos | Baja — el modelo descubre solo |
| Objetivo | Predecir una respuesta conocida | Descubrir estructura oculta |
| Tipo de resultado | Predicción concreta (clase o número) | Grupos, patrones, representaciones |
| Evaluación del modelo | Objetiva: accuracy, F1, RMSE... | Subjetiva: ¿tienen sentido los grupos? |
| Costo de datos | Alto — etiquetar es caro y lento | Bajo — los datos brutos suelen bastar |
| Precisión típica | Alta — cuando hay suficientes datos etiquetados | Variable — depende de la calidad de los datos |
| Casos de uso | Spam, diagnóstico, precios, fraude | Segmentación, anomalías, recomendación |
| Algoritmos clave | Random Forest, XGBoost, SVM, Redes Neuronales | K-Means, DBSCAN, PCA, Autoencoders |
¿Cuándo usar cada uno? — La guía de decisión
Usa aprendizaje SUPERVISADO cuando:
- ✅ Tienes datos etiquetados — ya sea porque los recopilaste históricamente o porque puedes etiquetarlos manualmente
- ✅ Sabes exactamente qué quieres predecir — "¿es spam?", "¿cuánto costará?", "¿se dará de baja?"
- ✅ Necesitas resultados precisos y medibles — puedes definir claramente qué es una predicción correcta
- ✅ El problema es de clasificación o regresión — categoría o número como output
Ejemplos del mundo real: detector de fraude bancario, precio estimado de un apartamento, predicción de abandono de clientes, diagnóstico médico por imagen.
Usa aprendizaje NO SUPERVISADO cuando:
- ✅ No tienes etiquetas — tus datos son brutos y sin clasificar
- ✅ Quieres explorar datos desconocidos — no sabes qué estructura tienen ni qué buscar
- ✅ Buscas segmentar o agrupar — "¿qué tipos de clientes tenemos?"
- ✅ Quieres detectar anomalías — comportamientos inusuales que no están etiquetados como tales
- ✅ Necesitas reducir complejidad — demasiadas variables para procesar directamente
Ejemplos del mundo real: segmentación de clientes para campañas de marketing, detección de transacciones sospechosas, sistema de recomendación de Spotify, agrupación de artículos de noticias.
El aprendizaje semi-supervisado — lo mejor de ambos mundos
Hay una tercera opción que no siempre se menciona pero que es muy común en la práctica: el aprendizaje semi-supervisado.
La situación real más frecuente en empresas: tienes millones de datos sin etiquetar y solo puedes etiquetar manualmente unos pocos miles (el etiquetado es caro). El semi-supervisado combina ambos enfoques:
Datos disponibles:
  1,000 emails etiquetados (spam/no spam)   ← etiquetados a mano
  500,000 emails sin etiquetar              ← datos brutos abundantes

Proceso semi-supervisado:
  1. Entrena un modelo básico con los 1,000 etiquetados
  2. Usa el modelo para "pseudoetiquetar" los 500,000 sin etiquetar
     (predice las etiquetas con alta confianza)
  3. Añade las pseudoetiquetas al conjunto de entrenamiento
  4. Reentrena con el dataset mucho más grande
  5. Resultado: modelo mucho mejor que con solo 1,000 ejemplos
Muchos de los avances en visión por computadora y NLP de los últimos años vienen de técnicas semi-supervisadas que aprovechan enormes cantidades de datos sin etiquetar.
Ejemplo real completo: el mismo problema con ambos enfoques
Para cerrar, veamos el mismo escenario resuelto con supervisado y no supervisado:
Escenario: Tienes datos de clientes de una tienda online y quieres entender mejor tu base de clientes.
# ============================================
# ENFOQUE SUPERVISADO
# "¿Qué clientes van a comprar de nuevo?"
# ============================================
# Necesitas: historial de clientes que SÍ recompraron y los que NO
# El modelo aprende: qué características predicen la recompra

from sklearn.ensemble import GradientBoostingClassifier

# X = características del cliente, y = recompró (1) o no (0)
modelo_supervisado = GradientBoostingClassifier()
modelo_supervisado.fit(X_train_etiquetado, y_train)

# Predice para clientes nuevos:
probabilidad_recompra = modelo_supervisado.predict_proba(X_nuevos_clientes)
# → Resultado: ["Cliente A: 92% probabilidad de recompra",
#               "Cliente B: 18% probabilidad de recompra"]
# Acción: enviar oferta personalizada a quienes tienen >70%


# ============================================
# ENFOQUE NO SUPERVISADO
# "¿Qué tipos de clientes tenemos?"
# ============================================
# No necesitas etiquetas — solo los datos de comportamiento
# El modelo descubre: qué segmentos naturales existen

from sklearn.cluster import KMeans

modelo_no_supervisado = KMeans(n_clusters=4, random_state=42)
segmentos = modelo_no_supervisado.fit_predict(X_todos_clientes)

# Interpretas los grupos encontrados:
# Segmento 0: "Compradores impulsivos" (muchas compras, bajo ticket)
# Segmento 1: "Clientes VIP"          (pocas compras, alto ticket)
# Segmento 2: "Inactivos en riesgo"   (sin compras en 90+ días)
# Segmento 3: "Compradores estacionales" (solo en temporadas)
# Acción: estrategia de marketing diferente para cada segmento
Ninguno de los dos es "mejor". Son herramientas para preguntas distintas. El supervisado responde: "¿cuánto/qué?" El no supervisado responde: "¿qué hay aquí que no sabíamos?"
Resumen: lo que aprendiste hoy
- ✅ Supervisado = datos con etiquetas (X + y) → predecir una respuesta conocida
- ✅ No supervisado = datos sin etiquetas (solo X) → descubrir estructura oculta
- ✅ Supervisado tiene dos tipos: clasificación (categorías) y regresión (números)
- ✅ No supervisado tiene tres tipos: clustering, reducción de dimensionalidad y reglas de asociación
- ✅ La evaluación del supervisado es objetiva (accuracy, F1); la del no supervisado es más interpretativa
- ✅ El etiquetado de datos es el mayor costo del aprendizaje supervisado
- ✅ K-Means, DBSCAN y PCA son los algoritmos no supervisados más usados
- ✅ Random Forest, XGBoost y Redes Neuronales dominan el supervisado
- ✅ El semi-supervisado combina ambos cuando hay pocos datos etiquetados
- ✅ Usa supervisado cuando sabes qué predecir; no supervisado cuando quieres explorar
🧪 ¿Tienes las bases de Python para trabajar con Machine Learning?
Todos los ejemplos de este artículo usan Python con scikit-learn. Para implementarlos necesitas dominar los fundamentos del lenguaje: listas, funciones, librerías y manejo de datos. Comprueba dónde estás:
👉 Test: Python Básico 👉 Test: Python Intermedio
¿Ya usabas alguno de estos enfoques sin saber cómo se llamaba? ¿Cuál te resulta más intuitivo: supervisado o no supervisado? ¿Tienes algún caso de uso en mente donde aplicarías cada uno? Cuéntanos en los comentarios 👇 — respondemos todos. 🚀

No hay comentarios todavía. Sé el primero en compartir tu opinión.