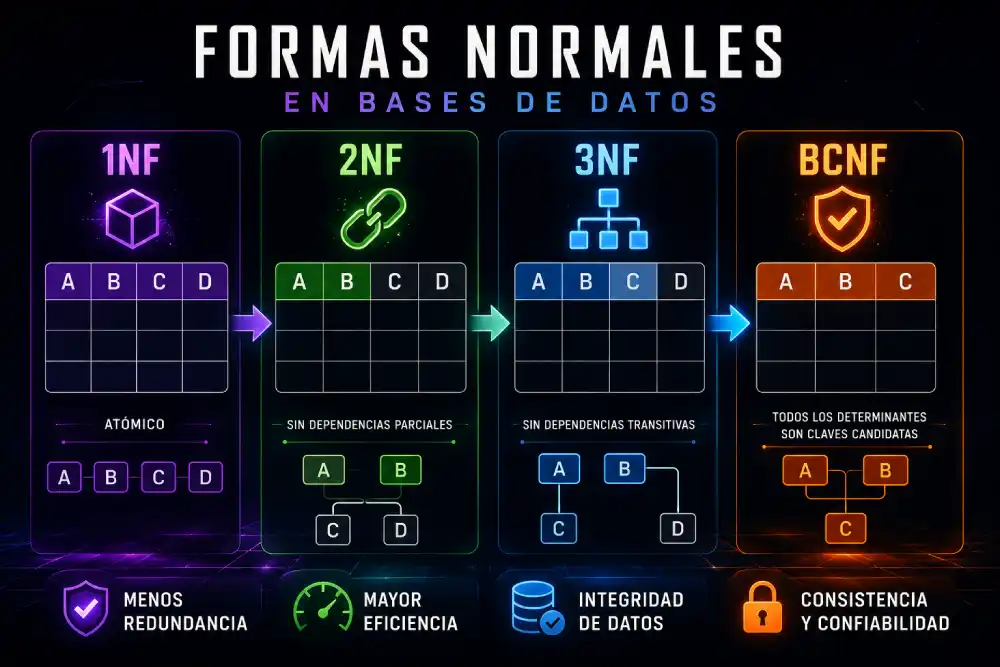
Cuando diseñas una base de datos sin seguir ningún criterio, el resultado casi siempre es el mismo: datos duplicados en varios lugares, inconsistencias cuando se actualiza un registro, anomalías al insertar o eliminar información, y consultas que se complican más de lo necesario.
La normalización es el proceso de organizar las tablas y columnas de una base de datos relacional para eliminar esos problemas. No es una opinión ni una preferencia: es un conjunto de reglas formales definidas por el matemático Edgar F. Codd en la década de 1970, y siguen siendo la base del diseño de bases de datos relacionales hoy en día.
En este artículo aprenderás qué es la normalización, por qué importa, y cómo aplicar las tres primeras formas normales paso a paso, que son las que necesitas en la práctica diaria.
El problema que resuelve la normalización
Antes de hablar de formas normales, veamos un ejemplo concreto del tipo de problemas que aparecen en una base de datos mal diseñada.
Imagina una tabla que guarda los pedidos de una tienda así:
| id_pedido | cliente_nombre | cliente_email | cliente_ciudad | producto1 | precio1 | producto2 | precio2 | producto3 | precio3 |
|---|---|---|---|---|---|---|---|---|---|
| 1 | Ana García | ana@mail.com | Madrid | Laptop | 1299.99 | Mouse | 45.50 | NULL | NULL |
| 2 | Ana García | ana@mail.com | Madrid | Teclado | 89.99 | NULL | NULL | NULL | NULL |
| 3 | Luis Pérez | luis@mail.com | Barcelona | Monitor | 349.99 | Mouse | 45.50 | Teclado | 89.99 |
Esta tabla tiene varios problemas graves:
- Anomalía de actualización: si Ana García cambia su email, hay que actualizarlo en todas sus filas. Si se olvida una, la base de datos tiene datos contradictorios.
- Anomalía de inserción: no puedes registrar a un cliente sin que tenga al menos un pedido.
- Anomalía de eliminación: si eliminas el único pedido de un cliente, pierdes todos sus datos de contacto.
- Columnas repetidas: ¿qué pasa si un pedido tiene cuatro productos? ¿Agregas producto4 y precio4? La estructura no es flexible.
- Datos duplicados: el nombre, email y ciudad de Ana aparecen dos veces.
La normalización elimina todos estos problemas de forma sistemática.
Conceptos previos: dependencias funcionales
Para entender las formas normales necesitas entender qué es una dependencia funcional. Decimos que la columna B depende funcionalmente de la columna A cuando conocer el valor de A determina de forma única el valor de B.
Notación: A → B (A determina B).
Ejemplos concretos:
id_cliente → nombre_cliente: conocer el ID del cliente determina su nombre.id_producto → precio: conocer el ID del producto determina su precio.id_pedido, id_producto → cantidad: la cantidad de un producto en un pedido depende de ambos juntos, no de uno solo.
También necesitas entender qué es la clave primaria: el atributo o conjunto de atributos que identifica de forma única cada fila de una tabla. Y la clave candidata: cualquier atributo o conjunto de atributos que podría servir como clave primaria.
Primera Forma Normal (1FN)
Una tabla está en Primera Forma Normal cuando cumple estas condiciones:
- Cada columna contiene un solo valor atómico (indivisible). No puede haber listas, conjuntos o grupos de valores en una celda.
- Cada columna tiene un nombre único.
- No hay grupos de columnas repetidos (como producto1, producto2, producto3).
- Cada fila es única e identificable por una clave primaria.
La tabla del ejemplo anterior viola la 1FN de dos formas: tiene columnas repetidas (producto1/precio1, producto2/precio2...) y puede tener valores NULL que representan ausencia de información.
Cómo aplicar la 1FN
Para llevar esa tabla a 1FN, eliminas las columnas repetidas y creas una fila por cada combinación de pedido y producto:
Antes (viola 1FN):
| id_pedido | cliente_nombre | cliente_email | producto1 | precio1 | producto2 | precio2 |
|---|---|---|---|---|---|---|
| 1 | Ana García | ana@mail.com | Laptop | 1299.99 | Mouse | 45.50 |
Después (cumple 1FN):
| id_pedido | cliente_nombre | cliente_email | producto | precio |
|---|---|---|---|---|
| 1 | Ana García | ana@mail.com | Laptop | 1299.99 |
| 1 | Ana García | ana@mail.com | Mouse | 45.50 |
Ahora la tabla está en 1FN. Pero aún tiene problemas: el nombre y email de Ana se repiten en cada fila de sus pedidos. Eso es la anomalía que resuelve la Segunda Forma Normal.
Segunda Forma Normal (2FN)
Una tabla está en Segunda Forma Normal cuando:
- Ya está en 1FN.
- Todos los atributos que no son parte de la clave primaria dependen de toda la clave primaria, no solo de una parte de ella.
La 2FN solo es relevante cuando la clave primaria está formada por más de una columna (clave compuesta). Si la clave primaria es una sola columna, la tabla ya cumple automáticamente la 2FN (siempre que esté en 1FN).
En la tabla anterior, la clave primaria después de aplicar 1FN sería la combinación (id_pedido, producto) porque esos dos valores juntos identifican cada fila de forma única.
Ahora analicemos las dependencias:
(id_pedido, producto) → precio: el precio de un producto en un pedido depende de ambos. ✅ Dependencia completa.id_pedido → cliente_nombre: el nombre del cliente depende solo del id_pedido, no del producto. ❌ Dependencia parcial.id_pedido → cliente_email: igual que el anterior. ❌ Dependencia parcial.
Las dependencias parciales violan la 2FN. Para corregirlo, separas los datos en tablas distintas según de qué parte de la clave dependen.
Cómo aplicar la 2FN
Antes (viola 2FN — dependencias parciales):
| id_pedido (PK) | producto (PK) | cliente_nombre | cliente_email | precio |
|---|---|---|---|---|
| 1 | Laptop | Ana García | ana@mail.com | 1299.99 |
| 1 | Mouse | Ana García | ana@mail.com | 45.50 |
| 2 | Teclado | Ana García | ana@mail.com | 89.99 |
Después (cumple 2FN — tres tablas separadas):
Tabla pedidos:
| id_pedido (PK) | id_cliente | fecha |
|---|---|---|
| 1 | 1 | 2024-06-01 |
| 2 | 1 | 2024-06-10 |
Tabla clientes:
| id_cliente (PK) | nombre | |
|---|---|---|
| 1 | Ana García | ana@mail.com |
Tabla detalle_pedidos:
| id_pedido (PK) | producto (PK) | precio |
|---|---|---|
| 1 | Laptop | 1299.99 |
| 1 | Mouse | 45.50 |
| 2 | Teclado | 89.99 |
Ahora el nombre y email de Ana solo aparecen una vez. Si cambia su email, se actualiza en un solo lugar. Pero todavía hay un problema potencial que resuelve la Tercera Forma Normal.
Tercera Forma Normal (3FN)
Una tabla está en Tercera Forma Normal cuando:
- Ya está en 2FN.
- Ningún atributo no clave depende de otro atributo no clave. Es decir, no existen dependencias transitivas.
Una dependencia transitiva ocurre cuando: A → B y B → C, lo que implica que A → C de forma indirecta a través de B. Si A es la clave primaria y C es un atributo no clave, entonces C depende transitivamente de la clave.
Veamos un ejemplo. Supongamos que la tabla de clientes tiene también la provincia y el código postal:
| id_cliente (PK) | nombre | codigo_postal | ciudad | provincia | |
|---|---|---|---|---|---|
| 1 | Ana García | ana@mail.com | 28001 | Madrid | Madrid |
| 2 | Luis Pérez | luis@mail.com | 08001 | Barcelona | Cataluña |
| 3 | María López | maria@mail.com | 28001 | Madrid | Madrid |
Analicemos las dependencias:
id_cliente → codigo_postal: cada cliente tiene un código postal. ✅codigo_postal → ciudad: el código postal determina la ciudad. ⚠️codigo_postal → provincia: el código postal determina la provincia. ⚠️
Existe una dependencia transitiva: id_cliente → codigo_postal → ciudad. La ciudad no depende directamente del cliente, sino del código postal. Esto viola la 3FN.
El problema es práctico: si el código postal 28001 cambia de ciudad (algo poco probable pero posible en ejemplos de diseño), habría que actualizar todas las filas que lo tienen. Y si dos clientes tienen el mismo código postal, la ciudad se repite.
Cómo aplicar la 3FN
Se extrae la dependencia transitiva a su propia tabla:
Tabla clientes (después de 3FN):
| id_cliente (PK) | nombre | codigo_postal | |
|---|---|---|---|
| 1 | Ana García | ana@mail.com | 28001 |
| 2 | Luis Pérez | luis@mail.com | 08001 |
| 3 | María López | maria@mail.com | 28001 |
Tabla codigos_postales (nueva):
| codigo_postal (PK) | ciudad | provincia |
|---|---|---|
| 28001 | Madrid | Madrid |
| 08001 | Barcelona | Cataluña |
Ahora la ciudad y la provincia de Madrid solo aparecen una vez, aunque haya mil clientes con código postal 28001. Si cambian, se actualiza en un solo lugar.
El ejemplo completo: de una tabla a un esquema normalizado
Repasemos todo el proceso desde el principio. Partimos de esta tabla desnormalizada:
| id_pedido | cliente_nombre | cliente_email | cod_postal | ciudad | producto1 | precio1 | cantidad1 | producto2 | precio2 | cantidad2 |
|---|---|---|---|---|---|---|---|---|---|---|
| 1 | Ana García | ana@mail.com | 28001 | Madrid | Laptop | 1299.99 | 1 | Mouse | 45.50 | 2 |
Y llegamos a este esquema en 3FN con SQL:
-- Tabla de ciudades / códigos postales (elimina dependencias transitivas)
CREATE TABLE codigos_postales (
  codigo_postal  CHAR(5)      PRIMARY KEY,
  ciudad         VARCHAR(100) NOT NULL,
  provincia      VARCHAR(100) NOT NULL
);

-- Tabla de clientes (sin dependencias transitivas ni parciales)
CREATE TABLE clientes (
  id             INT          AUTO_INCREMENT PRIMARY KEY,
  nombre         VARCHAR(100) NOT NULL,
  email          VARCHAR(100) UNIQUE NOT NULL,
  codigo_postal  CHAR(5),
  FOREIGN KEY (codigo_postal) REFERENCES codigos_postales(codigo_postal)
);

-- Tabla de productos (entidad propia)
CREATE TABLE productos (
  id             INT            AUTO_INCREMENT PRIMARY KEY,
  nombre         VARCHAR(100)   NOT NULL,
  precio_base    DECIMAL(10, 2) NOT NULL,
  categoria      VARCHAR(50)
);

-- Tabla de pedidos (relaciona clientes con sus pedidos)
CREATE TABLE pedidos (
  id             INT  AUTO_INCREMENT PRIMARY KEY,
  id_cliente     INT  NOT NULL,
  fecha          DATE NOT NULL,
  estado         VARCHAR(20) DEFAULT 'pendiente',
  FOREIGN KEY (id_cliente) REFERENCES clientes(id)
);

-- Tabla de detalle (relaciona pedidos con productos: clave compuesta)
CREATE TABLE detalle_pedidos (
  id_pedido      INT            NOT NULL,
  id_producto    INT            NOT NULL,
  cantidad       INT            NOT NULL,
  precio_unit    DECIMAL(10, 2) NOT NULL,
  PRIMARY KEY (id_pedido, id_producto),
  FOREIGN KEY (id_pedido)   REFERENCES pedidos(id),
  FOREIGN KEY (id_producto) REFERENCES productos(id)
);
Este esquema ya no tiene ninguna de las anomalías del diseño original:
- Actualizar el email de un cliente: un solo registro en la tabla clientes.
- Agregar un cliente sin pedidos: posible, se inserta en la tabla clientes.
- Eliminar un pedido: no se pierde ningún dato del cliente ni del producto.
- Un pedido con 100 productos: 100 filas en detalle_pedidos, sin cambiar la estructura.
- Cambiar el precio de un producto: un solo registro en la tabla productos.
Formas normales más avanzadas
Más allá de la 3FN existen otras formas normales. No las necesitarás en la mayoría de los proyectos, pero es útil saber que existen.
Forma Normal de Boyce-Codd (FNBC)
Una versión más estricta de la 3FN. Resuelve casos extremos donde hay múltiples claves candidatas que se solapan. En la práctica, una tabla en 3FN suele estar también en FNBC a menos que tenga una estructura de claves candidatas muy especial.
-- Ejemplo de violación de FNBC (raro en la práctica):
-- Una tabla de horarios donde un profesor solo puede dar una materia,
-- pero en un aula pueden coincidir varios profesores.
-- La clave primaria es (aula, horario) pero también
-- (profesor, horario) es una clave candidata.
-- Si profesor → materia, entonces hay dependencias
-- desde un determinante (profesor) que no es superclave.
Cuarta Forma Normal (4FN)
Elimina las dependencias multivaluadas: situaciones donde una columna puede tener múltiples valores independientes asociados a una clave. Por ejemplo, si un empleado puede hablar varios idiomas y tener varias habilidades, esas dos relaciones son independientes entre sí y deben estar en tablas separadas.
-- Viola 4FN: mezcla dos relaciones independientes
-- empleado_habilidades_idiomas
-- id_empleado | habilidad    | idioma
-- 1           | Python       | Inglés
-- 1           | Python       | Francés
-- 1           | JavaScript   | Inglés
-- 1           | JavaScript   | Francés  (fila forzada, sin info nueva)

-- Cumple 4FN: tablas separadas para cada relación
CREATE TABLE empleado_habilidades (id_empleado INT, habilidad VARCHAR(50));
CREATE TABLE empleado_idiomas     (id_empleado INT, idioma    VARCHAR(50));
Quinta Forma Normal (5FN)
Elimina las dependencias de join: casos donde la información de una tabla puede reconstruirse a partir de la unión de varias tablas más pequeñas. Es extremadamente rara en aplicaciones reales y su análisis formal es muy complejo.
Normalización vs desnormalización
La normalización resuelve problemas de integridad y redundancia, pero tiene un coste: para obtener datos que están en varias tablas necesitas hacer JOINs, y los JOINs tienen un coste de rendimiento en consultas sobre millones de registros.
La desnormalización es el proceso deliberado de introducir cierta redundancia en el esquema para mejorar el rendimiento de las consultas. Es una decisión de diseño consciente que se toma después de normalizar, no antes.
-- Ejemplo de desnormalización deliberada por rendimiento:
-- En lugar de hacer un JOIN entre pedidos, detalle y productos
-- para obtener el total de cada pedido, guardas el total precalculado:

ALTER TABLE pedidos ADD COLUMN total DECIMAL(10, 2);

-- El total se actualiza cada vez que se modifica el detalle.
-- Pierdes algo de integridad a cambio de consultas mucho más rápidas
-- en sistemas con millones de pedidos.
La regla práctica es: normaliza primero hasta al menos la 3FN, y desnormaliza después solo donde tengas evidencia real de un problema de rendimiento. La desnormalización prematura crea problemas de integridad que son mucho más difíciles de resolver que los de rendimiento.
Resumen de las tres primeras formas normales
| Forma Normal | Regla principal | Problema que resuelve |
|---|---|---|
| 1FN | Valores atómicos, sin grupos repetidos | Columnas repetidas, valores múltiples en una celda |
| 2FN | Sin dependencias parciales de la clave primaria | Datos de una entidad mezclados con los de otra |
| 3FN | Sin dependencias transitivas entre atributos no clave | Datos que dependen de otros datos, no directamente de la clave |
Señales de que tu base de datos necesita normalización
Más allá de la teoría, hay señales prácticas que indican que una tabla necesita ser normalizada:
- Tienes columnas con nombres como
telefono1,telefono2,telefono3. - Para actualizar un dato del sistema tienes que modificar muchas filas a la vez.
- Al eliminar una fila pierdes información sobre otra entidad diferente.
- Hay columnas que casi siempre tienen el mismo valor cuando otra columna tiene cierto valor.
- Una columna contiene listas separadas por comas:
etiquetas: "javascript,web,tutorial". - Hay muchos valores NULL en columnas que no deberían ser opcionales.
- Te das cuenta de que el mismo dato está guardado en más de un lugar.
Conclusión
La normalización es una de las habilidades más importantes del diseño de bases de datos. No se trata de memorizar reglas abstractas: se trata de entender qué significa que los datos estén bien organizados, sin redundancias innecesarias y sin anomalías que corrompan la integridad de la información.
Aplicar las tres primeras formas normales en tus diseños es suficiente para la gran mayoría de los casos. La 1FN elimina los grupos repetidos, la 2FN elimina las dependencias parciales y la 3FN elimina las dependencias transitivas. Cada una deja la base de datos un poco más limpia, predecible y fácil de mantener.
Recuerda siempre: normaliza primero para garantizar la integridad de los datos. Si luego hay problemas de rendimiento medibles y comprobados, entonces considera desnormalizar de forma quirúrgica y con plena conciencia de los compromisos que estás asumiendo.
Para seguir profundizando en el diseño de bases de datos, te recomendamos leer nuestros artículos sobre cómo funciona el modelo entidad-relación y los diagramas ER y sobre qué es una base de datos explicado con ejemplos, que son el punto de partida ideal antes de aplicar normalización.
No hay comentarios todavía. Sé el primero en compartir tu opinión.