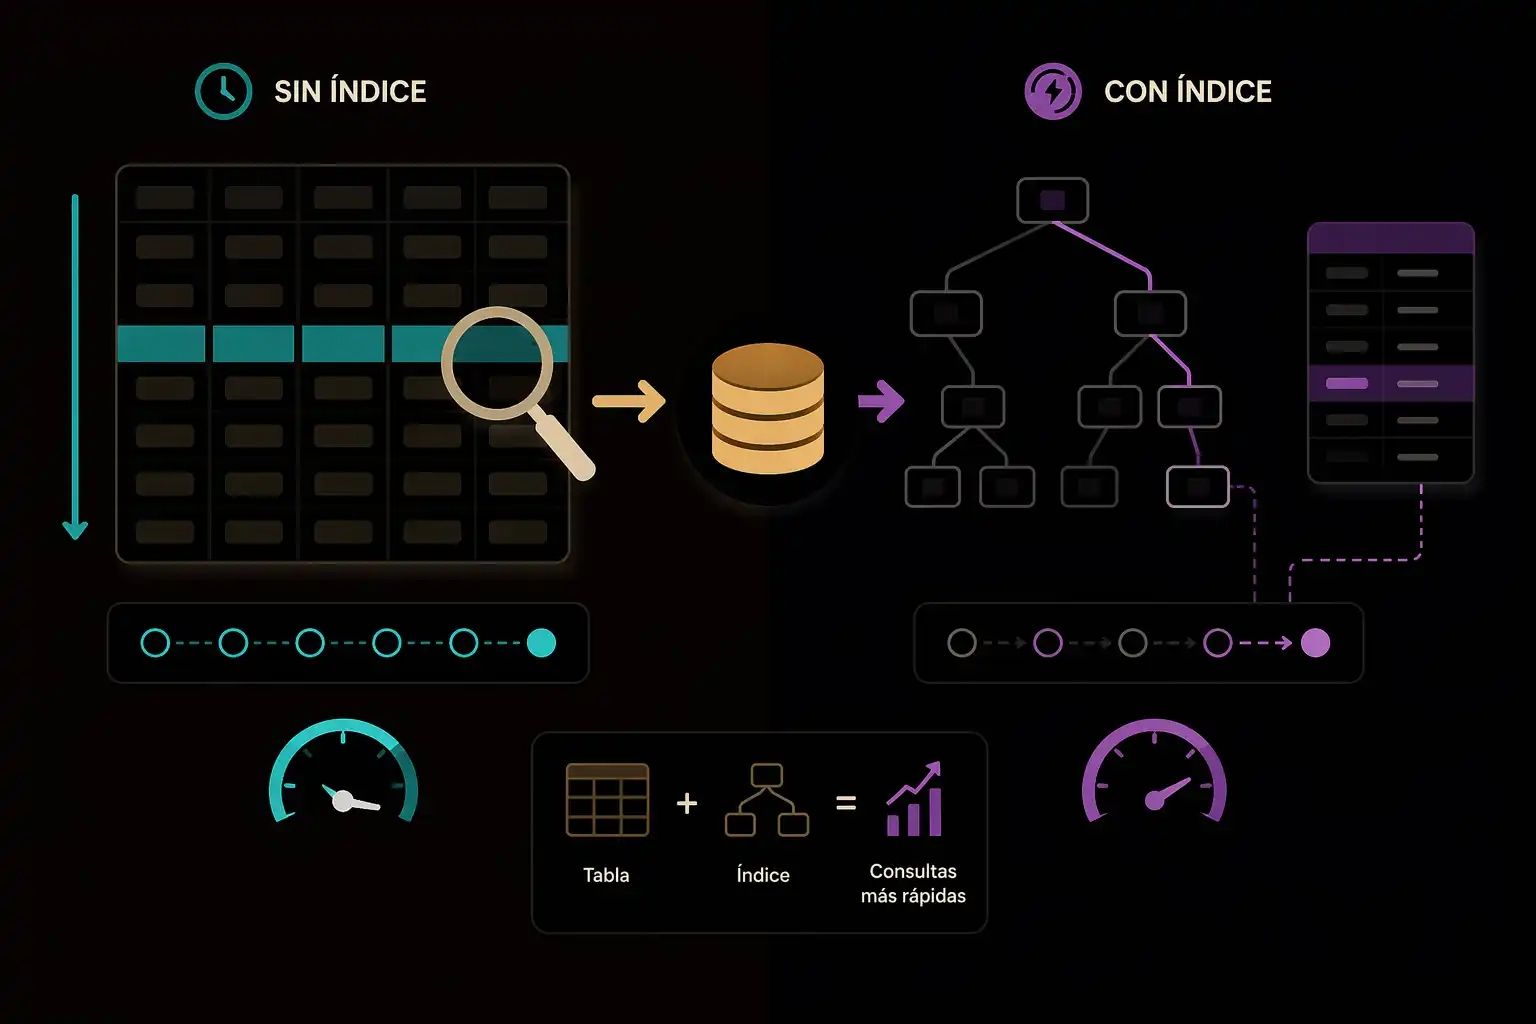
Tu consulta SQL funciona perfectamente en tu base de datos de prueba con 500 registros. La subes a producción, la base de datos crece hasta 2 millones de registros y, de repente, la misma consulta tarda 30 segundos en responder.
El 90% de las veces, la solución es un índice.
Los índices son una de las herramientas más poderosas — y más incomprendidas — del mundo SQL. Bien usados, convierten consultas de minutos en milisegundos. Mal usados, pueden hacer que tu base de datos sea más lenta de lo que era sin ellos.
En esta guía vas a entender qué son los índices, cómo funcionan por dentro, qué tipos existen y, lo más importante, cuándo crearlos y cuándo no.
¿Qué es un índice en SQL?
Un índice es una estructura de datos auxiliar que el motor de base de datos mantiene para encontrar filas de forma mucho más rápida, sin necesidad de recorrer toda la tabla registro a registro.
La analogía más usada — y la más precisa — es el índice de un libro. Si quieres encontrar el capítulo sobre "normalización" en un libro de 600 páginas, tienes dos opciones:
- 📖 Sin índice: leer el libro de principio a fin hasta encontrarlo (full table scan)
- 📑 Con índice: ir al índice alfabético al final del libro, encontrar "normalización → página 342" y saltar directamente
En bases de datos ocurre exactamente lo mismo. Sin índice, el motor revisa fila por fila. Con índice, salta directamente a donde están los datos.
-- Sin índice: el motor revisa las 2 millones de filas
SELECT * FROM clientes WHERE email = 'ana@ejemplo.com';
-- Tiempo: 8.4 segundos ⚠️

-- Con índice en la columna email: acceso directo
CREATE INDEX idx_clientes_email ON clientes(email);
SELECT * FROM clientes WHERE email = 'ana@ejemplo.com';
-- Tiempo: 0.003 segundos ✅  (~2800 veces más rápido)
Cómo funciona un índice por dentro: el árbol B
La mayoría de los índices en MySQL, PostgreSQL, SQL Server y Oracle usan internamente una estructura llamada árbol B (B-tree, de Balanced tree).
Un árbol B es una estructura jerárquica que organiza los valores de forma ordenada y balanceada. Para entenderlo, imagina que tienes que buscar el número 42 en una lista desordenada de 1 millón de números.
Sin índice (búsqueda lineal): revisas uno por uno. En el peor caso, 1,000,000 comparaciones.
Con árbol B (búsqueda logarítmica): divides el problema en mitades. ¿El número es mayor o menor que la mitad? Con esa lógica, encuentras cualquier valor en solo ~20 comparaciones, sin importar que haya 1 millón de registros.
-- Funcionamiento conceptual de un árbol B para buscar email='m@mail.com'
-- (los valores están ordenados en el árbol)

                    [g@mail.com]
                   /            \
        [b@mail.com]            [s@mail.com]
        /         \              /         \
  [a...]       [d...]       [m@mail.com]  [z...]
                                 ↑
                         ¡Encontrado en 3 pasos!
-- Sin índice hubiera revisado todas las filas una por una
Esta estructura logarítmica es la razón por la que los índices son tan dramáticamente más rápidos con millones de registros. 46 segundos pueden convertirse en 15 milisegundos.
Los índices que ya tienes sin saberlo
Antes de crear tu primer índice manual, debes saber que ya tienes índices creados automáticamente:
🔑 Índice de Clave Primaria (PRIMARY KEY)
Cuando defines una PRIMARY KEY, el motor crea automáticamente un índice único sobre esa columna. Por eso buscar por ID siempre es muy rápido.
-- Este CREATE TABLE crea automáticamente un índice en id
CREATE TABLE productos (
  id      INT PRIMARY KEY,  -- ← índice creado automáticamente
  nombre  VARCHAR(100),
  precio  DECIMAL(10,2)
);

-- Esta consulta es instantánea gracias al índice de PK
SELECT * FROM productos WHERE id = 5432;
🔒 Índice de Restricción UNIQUE
Las restricciones UNIQUE también crean un índice automáticamente.
CREATE TABLE usuarios (
  id     INT PRIMARY KEY,
  email  VARCHAR(100) UNIQUE  -- ← índice creado automáticamente
);
Crear índices manualmente: la sintaxis
Índice simple — una sola columna
-- Sintaxis básica
CREATE INDEX nombre_indice ON nombre_tabla (nombre_columna);

-- Ejemplo real: acelerar búsquedas por apellido
CREATE INDEX idx_clientes_apellido ON clientes(apellido);

-- Convención de nombres recomendada: idx_tabla_columna
CREATE INDEX idx_pedidos_fecha       ON pedidos(fecha);
CREATE INDEX idx_productos_categoria ON productos(categoria_id);
CREATE INDEX idx_empleados_dept      ON empleados(departamento_id);
Índice único — garantiza valores únicos
-- UNIQUE INDEX: no permite valores duplicados en la columna
CREATE UNIQUE INDEX idx_usuarios_email ON usuarios(email);

-- Equivale a añadir una restricción UNIQUE
-- Si intentas insertar un email duplicado → Error
Índice compuesto — múltiples columnas
-- Útil cuando las consultas filtran por varias columnas juntas
CREATE INDEX idx_pedidos_cliente_fecha ON pedidos(cliente_id, fecha);

-- Esta consulta aprovecha el índice compuesto:
SELECT * FROM pedidos
WHERE cliente_id = 101 AND fecha >= '2026-01-01';

-- Esta consulta NO aprovecha el índice compuesto:
SELECT * FROM pedidos WHERE fecha >= '2026-01-01';
-- Porque el índice empieza por cliente_id, no por fecha
⚠️ Regla de oro del índice compuesto: El orden importa. El índice solo funciona si la consulta incluye la primera columna (o las primeras columnas) del índice. Si el índice es (a, b, c), funciona para consultas que filtran por a, por a, b o por a, b, c. No funciona para filtrar solo por b o solo por c.
Índice de texto completo — búsquedas en texto largo
-- Para búsquedas de palabras dentro de campos de texto largo
-- MySQL
CREATE FULLTEXT INDEX idx_articulos_contenido
ON articulos(titulo, contenido);

-- Consulta con búsqueda de texto completo (MySQL)
SELECT * FROM articulos
WHERE MATCH(titulo, contenido) AGAINST('inteligencia artificial' IN BOOLEAN MODE);

-- PostgreSQL usa una sintaxis diferente con tsvector y tsquery
CREATE INDEX idx_articulos_fts ON articulos
USING gin(to_tsvector('spanish', titulo || ' ' || contenido));
Índice parcial — solo un subconjunto de filas
-- Solo indexa las filas que cumplen una condición
-- (soportado en PostgreSQL y SQL Server, no en MySQL básico)
CREATE INDEX idx_pedidos_pendientes ON pedidos(fecha)
WHERE estado = 'pendiente';

-- Muy útil cuando solo consultas frecuentemente un subconjunto:
-- "Dame todos los pedidos pendientes del último mes"
-- El índice es más pequeño y eficiente porque ignora los completados
Ver y eliminar índices
-- MySQL: ver índices de una tabla
SHOW INDEX FROM productos;

-- PostgreSQL: ver índices de una tabla
SELECT indexname, indexdef FROM pg_indexes
WHERE tablename = 'productos';

-- Eliminar un índice
DROP INDEX idx_clientes_apellido ON clientes;        -- MySQL
DROP INDEX idx_clientes_apellido;                    -- PostgreSQL/SQL Server
EXPLAIN — el microscopio de tus consultas
EXPLAIN es el comando más valioso para entender si tus índices están siendo usados. Te muestra el plan de ejecución: cómo el motor decide ejecutar tu consulta.
-- Antes de crear el índice
EXPLAIN SELECT * FROM clientes WHERE ciudad = 'Madrid';

-- Resultado típico sin índice:
-- +----+-------------+---------+------+------+------+---------+------+---------+-------------+
-- | id | select_type | table   | type | key  | rows | Extra                                   |
-- +----+-------------+---------+------+------+------+-----------------------------------------+
-- |  1 | SIMPLE      | clientes| ALL  | NULL | 1000000 | (Using where)                      |
-- ↑ type=ALL significa FULL TABLE SCAN: revisa las 1,000,000 filas ❌

-- Después de crear el índice
CREATE INDEX idx_clientes_ciudad ON clientes(ciudad);
EXPLAIN SELECT * FROM clientes WHERE ciudad = 'Madrid';

-- Resultado con índice:
-- +----+-------------+---------+------+-------------------+------+--------+
-- | id | select_type | table   | type | key               | rows | Extra  |
-- +----+-------------+---------+------+-------------------+------+--------+
-- |  1 | SIMPLE      | clientes| ref  | idx_clientes_ciudad| 847 |        |
-- ↑ type=ref y key=idx_clientes_ciudad: usa el índice, revisa solo 847 filas ✅
Los valores de la columna type de EXPLAIN (de mejor a peor):
| type | ¿Qué significa? | ¿Es bueno? |
|---|---|---|
const | Acceso por clave primaria o unique — 1 fila exacta | ✅ Óptimo |
eq_ref | JOIN por clave primaria — una fila por cada fila del join | ✅ Muy bueno |
ref | Usa un índice no único — devuelve varias filas | ✅ Bueno |
range | Usa un índice para un rango de valores (BETWEEN, >, <) | 🟡 Aceptable |
index | Recorre el índice completo (mejor que ALL, pero aún lento) | 🟡 Regular |
ALL | Full Table Scan — revisa toda la tabla fila por fila | ❌ Evitar |
Si ves type: ALL en una tabla grande, es casi siempre señal de que falta un índice.
El precio de los índices: impacto en escrituras
Los índices no son gratis. Tienen un costo que debes conocer antes de crearlos masivamente:
-- Sin índices: INSERT rápido
INSERT INTO ventas (cliente_id, producto_id, fecha, total)
VALUES (101, 5, NOW(), 299.99);
-- El motor solo inserta la fila → rápido

-- Con 5 índices en la tabla: INSERT más lento
INSERT INTO ventas (cliente_id, producto_id, fecha, total)
VALUES (101, 5, NOW(), 299.99);
-- El motor inserta la fila Y actualiza 5 estructuras B-tree → más lento
La regla práctica: cada índice adicional hace que las operaciones de INSERT, UPDATE y DELETE sean ligeramente más lentas, y ocupa espacio adicional en disco.
Esto no significa que no debas usar índices — significa que debes crearlos con criterio, solo en las columnas que realmente lo necesitan.
¿Cuándo crear un índice? — Las 5 reglas
✅ Regla 1: Siempre indexa las claves foráneas
-- Las claves foráneas se usan constantemente en JOINs
-- Sin índice, cada JOIN hace un full scan de la tabla hija
CREATE INDEX idx_pedidos_cliente ON pedidos(cliente_id);
CREATE INDEX idx_detalle_pedido  ON detalle_pedidos(pedido_id);
CREATE INDEX idx_detalle_producto ON detalle_pedidos(producto_id);
✅ Regla 2: Indexa columnas que aparecen frecuentemente en WHERE
-- Si esta consulta se ejecuta miles de veces al día, necesita índice
SELECT * FROM usuarios WHERE email = ?;
SELECT * FROM pedidos WHERE estado = 'pendiente';
SELECT * FROM logs WHERE fecha >= ? AND fecha < ?;

CREATE INDEX idx_usuarios_email  ON usuarios(email);
CREATE INDEX idx_pedidos_estado  ON pedidos(estado);
CREATE INDEX idx_logs_fecha      ON logs(fecha);
✅ Regla 3: Indexa columnas usadas en ORDER BY y GROUP BY
-- Sin índice: el motor ordena/agrupa todos los resultados en memoria
SELECT producto_id, SUM(total) FROM ventas
GROUP BY producto_id ORDER BY SUM(total) DESC;

-- Con índice, la operación es mucho más eficiente
CREATE INDEX idx_ventas_producto ON ventas(producto_id);
❌ Regla 4: NO indexes columnas de baja cardinalidad
-- BAJA CARDINALIDAD = pocos valores únicos posibles
-- Ejemplo: columna "activo" con solo valores TRUE/FALSE
-- El índice apenas ayuda porque el motor igual recupera la mitad de la tabla

-- ❌ Índice inútil — activo solo tiene 2 valores posibles
CREATE INDEX idx_usuarios_activo ON usuarios(activo);

-- ✅ Mejor opción: índice parcial (si la mayoría son activos y buscas inactivos)
CREATE INDEX idx_usuarios_inactivos ON usuarios(email) WHERE activo = FALSE;
❌ Regla 5: NO indexes todas las columnas por si acaso
-- ❌ Sobreindexación: 8 índices en una tabla con muchas escrituras
CREATE INDEX idx1 ON productos(nombre);
CREATE INDEX idx2 ON productos(precio);
CREATE INDEX idx3 ON productos(stock);
CREATE INDEX idx4 ON productos(categoria_id);
CREATE INDEX idx5 ON productos(proveedor_id);
CREATE INDEX idx6 ON productos(peso);
CREATE INDEX idx7 ON productos(color);
CREATE INDEX idx8 ON productos(fecha_creacion);
-- Cada INSERT/UPDATE ahora actualiza 8 estructuras B-tree ← muy lento

-- ✅ Solo crea índices para las columnas que realmente se filtran más
CREATE INDEX idx_productos_categoria ON productos(categoria_id);  -- JOIN frecuente
CREATE INDEX idx_productos_nombre    ON productos(nombre);        -- búsqueda de usuario
Errores comunes que anulan los índices
Hay situaciones donde tienes un índice pero el motor no lo usa porque la consulta está escrita de forma que lo "rompe":
❌ Usar funciones sobre la columna indexada
-- ❌ El índice en fecha NO se usa porque la función YEAR() lo envuelve
SELECT * FROM pedidos WHERE YEAR(fecha) = 2026;

-- ✅ Reescribir usando un rango para que el índice funcione
SELECT * FROM pedidos WHERE fecha >= '2026-01-01' AND fecha < '2027-01-01';
❌ Usar LIKE con comodín al inicio
-- ❌ El índice NO se usa: el % al inicio impide la búsqueda por árbol B
SELECT * FROM productos WHERE nombre LIKE '%laptop%';

-- ✅ El índice SÍ se usa: el % solo está al final (busca por prefijo)
SELECT * FROM productos WHERE nombre LIKE 'laptop%';

-- Para búsquedas en medio del texto usa FULLTEXT index
SELECT * FROM productos
WHERE MATCH(nombre) AGAINST('laptop' IN BOOLEAN MODE);
❌ Operaciones matemáticas sobre la columna indexada
-- ❌ El índice en precio NO se usa
SELECT * FROM productos WHERE precio * 1.21 > 100;

-- ✅ Mover la operación al otro lado de la comparación
SELECT * FROM productos WHERE precio > 100 / 1.21;
❌ Conversiones implícitas de tipo
-- Si cliente_id es INT pero pasas un string, el índice puede no usarse
SELECT * FROM pedidos WHERE cliente_id = '101';  -- '101' es string

-- ✅ Usar el tipo correcto
SELECT * FROM pedidos WHERE cliente_id = 101;    -- 101 es integer
❌ Usar OR en lugar de UNION para columnas diferentes
-- ❌ OR entre columnas diferentes puede hacer full scan aunque haya índices
SELECT * FROM clientes WHERE ciudad = 'Madrid' OR email = 'ana@mail.com';

-- ✅ UNION aprovecha ambos índices por separado
SELECT * FROM clientes WHERE ciudad = 'Madrid'
UNION
SELECT * FROM clientes WHERE email = 'ana@mail.com';
Ejemplo real: de 15 segundos a 500 ms
Este es el tipo de situación que encontrarás en proyectos reales:
-- Consulta lenta: reporte de ventas por cliente del último trimestre
SELECT
  c.nombre,
  COUNT(v.id)        AS num_ventas,
  SUM(v.total)       AS total_vendido
FROM ventas v
JOIN clientes c ON v.cliente_id = c.id
WHERE v.fecha >= '2026-01-01' AND v.fecha < '2026-04-01'
GROUP BY c.id, c.nombre
ORDER BY total_vendido DESC;

-- EXPLAIN muestra: full scan en ventas (5 millones de filas) → 15 segundos ❌
-- Diagnóstico con EXPLAIN:
EXPLAIN SELECT c.nombre, COUNT(v.id), SUM(v.total)
FROM ventas v JOIN clientes c ON v.cliente_id = c.id
WHERE v.fecha >= '2026-01-01' AND v.fecha < '2026-04-01'
GROUP BY c.id ORDER BY SUM(v.total) DESC;
-- Resultado: type=ALL en ventas, rows=5000000, no usa índice ← PROBLEMA-- Solución: índice compuesto en las columnas del WHERE y JOIN
CREATE INDEX idx_ventas_fecha_cliente ON ventas(fecha, cliente_id);
-- EXPLAIN después del índice:
-- type=range, key=idx_ventas_fecha_cliente, rows=45000 ← solo 45k filas
-- Tiempo después: 0.5 segundos ✅ (30 veces más rápido)Tabla resumen: tipos de índices
| Tipo de índice | ¿Para qué sirve? | ¿Cuándo usarlo? | MySQL | PostgreSQL |
|---|---|---|---|---|
| Simple (B-tree) | Búsquedas exactas y rangos en una columna | Columnas frecuentes en WHERE, JOIN, ORDER BY | ✅ | ✅ |
| UNIQUE | Garantiza unicidad + acelera búsquedas | Email, DNI, código de producto | ✅ | ✅ |
| Compuesto | Consultas que filtran por varias columnas juntas | WHERE col1 = ? AND col2 = ? | ✅ | ✅ |
| FULLTEXT | Búsqueda de palabras dentro de texto largo | Buscadores, artículos, descripciones | ✅ | ✅ (GIN) |
| Parcial | Solo indexa filas que cumplen una condición | Cuando solo consultas un subconjunto | ❌ | ✅ |
| Hash | Igualdad exacta ultra rápida (no funciona para rangos) | Búsquedas exactas por hash | 🔶 Memory | ✅ |
Resumen: lo que aprendiste hoy
- ✅ Un índice es una estructura B-tree auxiliar que permite encontrar filas sin recorrer toda la tabla
- ✅ Las PRIMARY KEY y UNIQUE crean índices automáticamente
- ✅ La sintaxis básica es:
CREATE INDEX nombre ON tabla(columna) - ✅ Los índices aceleran SELECT, JOIN, WHERE y ORDER BY
- ✅ Los índices ralentizan INSERT, UPDATE y DELETE (el índice también se actualiza)
- ✅ Siempre indexa las claves foráneas usadas en JOINs frecuentes
- ✅ Los índices compuestos siguen la regla del prefijo: el orden de columnas importa
- ✅ Usa
EXPLAINpara verificar si tus consultas están usando índices - ✅
type: ALLen EXPLAIN significa full scan — probablemente falta un índice - ✅ Las funciones sobre columnas indexadas, LIKE con % al inicio y conversiones de tipo anulan los índices
- ✅ No indexes todas las columnas — crea índices solo donde el rendimiento lo justifique
🧪 ¿Tienes bien sólidos tus fundamentos de SQL?
Los índices son SQL avanzado. Para aprovecharlos bien necesitas dominar SELECT, WHERE, JOIN y ORDER BY. Comprueba dónde estás antes de profundizar más en optimización:
👉 Test: SQL Básico 👉 Test: SQL vs NoSQL
¿Ya habías usado índices antes? ¿Has tenido alguna vez una consulta que tardaba minutos y un índice la solucionó? Cuéntanos en los comentarios 👇 — respondemos todos. 🚀
No hay comentarios todavía. Sé el primero en compartir tu opinión.