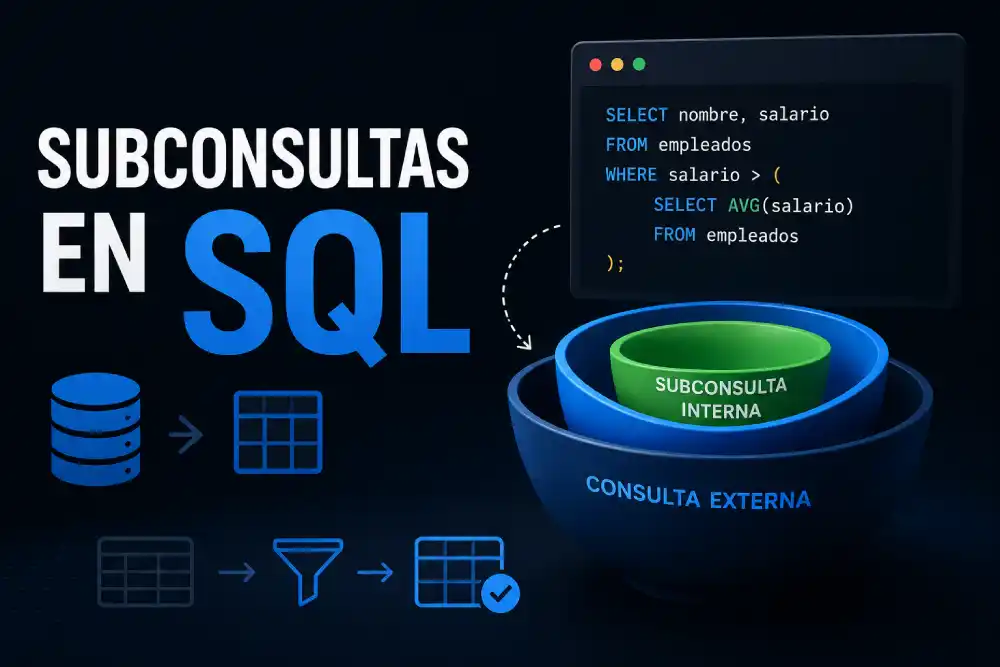
Una subconsulta es una consulta SQL escrita dentro de otra consulta. Es una de las herramientas más potentes del lenguaje: te permite resolver problemas complejos de forma elegante, filtrar datos basándote en el resultado de otra consulta, y construir lógica en capas que sería muy difícil expresar de otra manera.
En esta guía aprenderás todos los tipos de subconsultas con ejemplos reales sobre un esquema de base de datos de una tienda online, desde los casos más simples hasta los más avanzados.
El esquema de ejemplo
Todos los ejemplos de esta guía usan estas cuatro tablas. Créalas en tu base de datos MySQL o PostgreSQL para seguir los ejemplos:
-- Clientes
CREATE TABLE clientes (
  id        INT PRIMARY KEY AUTO_INCREMENT,
  nombre    VARCHAR(100) NOT NULL,
  email     VARCHAR(100) UNIQUE NOT NULL,
  ciudad    VARCHAR(50),
  pais      VARCHAR(50) DEFAULT 'España'
);

-- Productos
CREATE TABLE productos (
  id         INT PRIMARY KEY AUTO_INCREMENT,
  nombre     VARCHAR(100) NOT NULL,
  categoria  VARCHAR(50),
  precio     DECIMAL(10, 2) NOT NULL,
  stock      INT DEFAULT 0
);

-- Pedidos
CREATE TABLE pedidos (
  id          INT PRIMARY KEY AUTO_INCREMENT,
  cliente_id  INT REFERENCES clientes(id),
  fecha       DATE NOT NULL,
  estado      VARCHAR(20) DEFAULT 'pendiente',
  total       DECIMAL(10, 2) NOT NULL
);

-- Líneas de pedido (detalle de qué productos lleva cada pedido)
CREATE TABLE lineas_pedido (
  id           INT PRIMARY KEY AUTO_INCREMENT,
  pedido_id    INT REFERENCES pedidos(id),
  producto_id  INT REFERENCES productos(id),
  cantidad     INT NOT NULL,
  precio_unit  DECIMAL(10, 2) NOT NULL
);
¿Qué es exactamente una subconsulta?
Una subconsulta (también llamada subquery o consulta anidada) es una sentencia SELECT que aparece dentro de otra sentencia SQL. La consulta exterior se llama consulta principal y la interior se llama subconsulta. La subconsulta siempre va entre paréntesis.
-- Estructura básica
SELECT columnas
FROM tabla
WHERE columna = (
    SELECT columna        -- ← esta es la subconsulta
    FROM otra_tabla
    WHERE condicion
);
El motor de base de datos ejecuta primero la subconsulta, obtiene su resultado, y luego usa ese resultado para ejecutar la consulta principal. La subconsulta puede devolver un valor único, una lista de valores o una tabla completa, y eso determina cómo se usa en la consulta exterior.
Subconsultas escalares: devuelven un único valor
Una subconsulta escalar devuelve exactamente una fila y una columna: un valor único. Se puede usar en cualquier lugar donde pondrías un valor: en WHERE, en SELECT, en HAVING.
-- ¿Qué clientes han gastado más que la media de todos los clientes?
SELECT
  c.nombre,
  SUM(p.total) AS total_gastado
FROM clientes c
JOIN pedidos p ON p.cliente_id = c.id
GROUP BY c.id, c.nombre
HAVING SUM(p.total) > (
    SELECT AVG(total)    -- subconsulta escalar: devuelve un número
    FROM pedidos
);
-- Mostrar el precio de cada producto junto con la diferencia respecto al precio medio
SELECT
  nombre,
  precio,
  precio - (SELECT AVG(precio) FROM productos) AS diferencia_con_media,
  CASE
    WHEN precio > (SELECT AVG(precio) FROM productos) THEN 'caro'
    WHEN precio < (SELECT AVG(precio) FROM productos) THEN 'barato'
    ELSE 'en la media'
  END AS clasificacion
FROM productos
ORDER BY precio DESC;
-- Encontrar el producto más caro de cada categoría
SELECT
  categoria,
  nombre,
  precio
FROM productos p1
WHERE precio = (
    SELECT MAX(precio)
    FROM productos p2
    WHERE p2.categoria = p1.categoria   -- referencia a la consulta exterior
)
ORDER BY categoria;
Este último ejemplo es una subconsulta correlacionada: la subconsulta hace referencia a una columna de la consulta exterior (p1.categoria). Se ejecuta una vez por cada fila de la consulta principal. Las veremos en detalle más adelante.
Subconsultas en el WHERE con operadores de comparación
Cuando la subconsulta devuelve un valor único, puedes usarla con cualquier operador de comparación: =, !=, >, <, >=, <=.
-- Clientes que han hecho el pedido más grande de toda la historia
SELECT nombre, email
FROM clientes
WHERE id = (
    SELECT cliente_id
    FROM pedidos
    ORDER BY total DESC
    LIMIT 1
);
-- Productos con un precio superior al producto más caro de la categoría 'Accesorios'
SELECT nombre, precio, categoria
FROM productos
WHERE precio > (
    SELECT MAX(precio)
    FROM productos
    WHERE categoria = 'Accesorios'
)
ORDER BY precio;
-- Pedidos realizados en el mismo mes que el primer pedido registrado en el sistema
SELECT id, cliente_id, fecha, total
FROM pedidos
WHERE MONTH(fecha) = (
    SELECT MONTH(MIN(fecha)) FROM pedidos
)
AND YEAR(fecha) = (
    SELECT YEAR(MIN(fecha))  FROM pedidos
)
ORDER BY fecha;
Subconsultas con IN y NOT IN
Cuando la subconsulta devuelve una lista de valores (múltiples filas, una sola columna), usa IN para comprobar si un valor pertenece a esa lista, o NOT IN para lo contrario.
-- Clientes que han realizado al menos un pedido
SELECT nombre, email, ciudad
FROM clientes
WHERE id IN (
    SELECT DISTINCT cliente_id
    FROM pedidos
);
-- Clientes que NUNCA han realizado ningún pedido
SELECT nombre, email, ciudad
FROM clientes
WHERE id NOT IN (
    SELECT DISTINCT cliente_id
    FROM pedidos
    WHERE cliente_id IS NOT NULL   -- importante: NOT IN con NULLs da resultados incorrectos
);
-- Productos que aparecen en al menos un pedido completado (estado = 'completado')
SELECT nombre, precio, categoria
FROM productos
WHERE id IN (
    SELECT DISTINCT lp.producto_id
    FROM lineas_pedido lp
    JOIN pedidos p ON p.id = lp.pedido_id
    WHERE p.estado = 'completado'
);
-- Productos que nunca se han vendido
SELECT nombre, precio, stock
FROM productos
WHERE id NOT IN (
    SELECT DISTINCT producto_id
    FROM lineas_pedido
    WHERE producto_id IS NOT NULL
);
Cuidado con NOT IN y valores NULL: si la subconsulta devuelve algún NULL, NOT IN siempre devuelve falso para todas las filas. Siempre añade WHERE columna IS NOT NULL en la subconsulta o usa NOT EXISTS en su lugar (es más seguro y suele ser más eficiente).
Subconsultas con EXISTS y NOT EXISTS
EXISTS devuelve verdadero si la subconsulta devuelve al menos una fila. No le importa qué datos devuelve, solo si devuelve algo. Es la alternativa más segura y eficiente a IN/NOT IN en la mayoría de casos.
-- Clientes que han realizado al menos un pedido (equivalente al IN anterior, pero más eficiente)
SELECT nombre, email
FROM clientes c
WHERE EXISTS (
    SELECT 1        -- el 1 es convención: solo nos importa si existe, no qué devuelve
    FROM pedidos p
    WHERE p.cliente_id = c.id
);
-- Clientes que nunca han pedido (más seguro que NOT IN con posibles NULLs)
SELECT nombre, email, ciudad
FROM clientes c
WHERE NOT EXISTS (
    SELECT 1
    FROM pedidos p
    WHERE p.cliente_id = c.id
);
-- Productos que han sido pedidos por clientes de Madrid
SELECT p.nombre, p.precio
FROM productos p
WHERE EXISTS (
    SELECT 1
    FROM lineas_pedido lp
    JOIN pedidos pe   ON pe.id = lp.pedido_id
    JOIN clientes cl  ON cl.id = pe.cliente_id
    WHERE lp.producto_id = p.id
    AND cl.ciudad = 'Madrid'
);
-- Pedidos que contienen TODOS los productos de la categoría 'Electrónica'
-- (problema de división relacional, clásico en SQL)
SELECT pe.id, pe.fecha, pe.total
FROM pedidos pe
WHERE NOT EXISTS (
    -- productos de electrónica que NO están en este pedido
    SELECT 1
    FROM productos pr
    WHERE pr.categoria = 'Electrónica'
    AND NOT EXISTS (
        SELECT 1
        FROM lineas_pedido lp
        WHERE lp.pedido_id = pe.id
        AND lp.producto_id = pr.id
    )
);
Subconsultas con ANY y ALL
ANY devuelve verdadero si la condición se cumple para al menos un valor de la lista. ALL devuelve verdadero solo si se cumple para todos los valores.
-- Productos más caros que AL MENOS UNO de la categoría 'Accesorios'
-- (equivale a: más caros que el mínimo de Accesorios)
SELECT nombre, precio
FROM productos
WHERE precio > ANY (
    SELECT precio
    FROM productos
    WHERE categoria = 'Accesorios'
)
AND categoria != 'Accesorios';
-- Productos más caros que TODOS los de la categoría 'Accesorios'
-- (equivale a: más caros que el máximo de Accesorios)
SELECT nombre, precio
FROM productos
WHERE precio > ALL (
    SELECT precio
    FROM productos
    WHERE categoria = 'Accesorios'
)
AND categoria != 'Accesorios';
-- Clientes cuyo total de compras supera el de CUALQUIER cliente de Barcelona
SELECT c.nombre, SUM(p.total) AS total_compras
FROM clientes c
JOIN pedidos p ON p.cliente_id = c.id
GROUP BY c.id, c.nombre
HAVING SUM(p.total) > ALL (
    SELECT SUM(p2.total)
    FROM clientes c2
    JOIN pedidos p2 ON p2.cliente_id = c2.id
    WHERE c2.ciudad = 'Barcelona'
    GROUP BY c2.id
);
Subconsultas correlacionadas
Una subconsulta correlacionada hace referencia a columnas de la consulta exterior. Se ejecuta una vez por cada fila que procesa la consulta principal, lo que la hace más lenta pero también mucho más expresiva.
-- Para cada cliente, mostrar cuántos pedidos ha hecho y su importe medio
SELECT
  c.nombre,
  c.ciudad,
  (SELECT COUNT(*)   FROM pedidos p WHERE p.cliente_id = c.id) AS num_pedidos,
  (SELECT AVG(total) FROM pedidos p WHERE p.cliente_id = c.id) AS importe_medio
FROM clientes c
ORDER BY num_pedidos DESC;
-- Ranking de productos por ventas dentro de su categoría
SELECT
  nombre,
  categoria,
  precio,
  (
    SELECT COUNT(*)
    FROM productos p2
    WHERE p2.categoria = p1.categoria
    AND p2.precio > p1.precio
  ) + 1 AS ranking_en_categoria
FROM productos p1
ORDER BY categoria, ranking_en_categoria;
-- El pedido más reciente de cada cliente
SELECT
  c.nombre,
  (
    SELECT MAX(p.fecha)
    FROM pedidos p
    WHERE p.cliente_id = c.id
  ) AS ultimo_pedido,
  (
    SELECT p.total
    FROM pedidos p
    WHERE p.cliente_id = c.id
    ORDER BY p.fecha DESC
    LIMIT 1
  ) AS importe_ultimo_pedido
FROM clientes c
WHERE EXISTS (SELECT 1 FROM pedidos p WHERE p.cliente_id = c.id);
Subconsultas en el FROM: tablas derivadas
Puedes usar una subconsulta en la cláusula FROM como si fuera una tabla. A esto se le llama tabla derivada o subquery en el FROM. Siempre debe ir acompañada de un alias.
-- Clientes con más de 3 pedidos y su gasto total
SELECT
  resumen.nombre,
  resumen.num_pedidos,
  resumen.gasto_total
FROM (
    SELECT
      c.nombre,
      COUNT(p.id)    AS num_pedidos,
      SUM(p.total)   AS gasto_total
    FROM clientes c
    JOIN pedidos p ON p.cliente_id = c.id
    GROUP BY c.id, c.nombre
) AS resumen    -- alias obligatorio para la tabla derivada
WHERE resumen.num_pedidos > 3
ORDER BY resumen.gasto_total DESC;
-- Top 3 categorías por ingresos y su porcentaje sobre el total
SELECT
  cat.categoria,
  cat.ingresos,
  ROUND(cat.ingresos / totales.gran_total * 100, 2) AS porcentaje
FROM (
    SELECT
      pr.categoria,
      SUM(lp.cantidad * lp.precio_unit) AS ingresos
    FROM lineas_pedido lp
    JOIN productos pr ON pr.id = lp.producto_id
    GROUP BY pr.categoria
) AS cat
CROSS JOIN (
    SELECT SUM(lp.cantidad * lp.precio_unit) AS gran_total
    FROM lineas_pedido lp
) AS totales
ORDER BY cat.ingresos DESC
LIMIT 3;
-- Percentiles de gasto: clasificar clientes en cuartiles
SELECT
  nombre,
  gasto_total,
  NTILE(4) OVER (ORDER BY gasto_total) AS cuartil
FROM (
    SELECT
      c.nombre,
      SUM(p.total) AS gasto_total
    FROM clientes c
    JOIN pedidos p ON p.cliente_id = c.id
    GROUP BY c.id, c.nombre
) AS gastos_cliente
ORDER BY gasto_total DESC;
CTEs: la alternativa moderna a las subconsultas anidadas
Las Common Table Expressions (CTE) son una forma de definir subconsultas con nombre antes de la consulta principal usando la cláusula WITH. Hacen el código mucho más legible que las subconsultas anidadas y se pueden reutilizar varias veces dentro de la misma consulta.
-- Sin CTE: difícil de leer con subconsultas anidadas
SELECT nombre, gasto_total
FROM (
    SELECT c.nombre, SUM(p.total) AS gasto_total
    FROM clientes c JOIN pedidos p ON p.cliente_id = c.id
    GROUP BY c.id, c.nombre
) resumen
WHERE gasto_total > (
    SELECT AVG(gasto_cliente)
    FROM (
        SELECT SUM(total) AS gasto_cliente
        FROM pedidos GROUP BY cliente_id
    ) subgastos
);


-- Con CTE: mucho más legible
WITH gasto_por_cliente AS (
    SELECT
      c.id,
      c.nombre,
      SUM(p.total) AS gasto_total
    FROM clientes c
    JOIN pedidos p ON p.cliente_id = c.id
    GROUP BY c.id, c.nombre
),
media_gasto AS (
    SELECT AVG(gasto_total) AS media
    FROM gasto_por_cliente
)
SELECT
  g.nombre,
  g.gasto_total,
  ROUND(g.gasto_total - m.media, 2) AS diferencia_vs_media
FROM gasto_por_cliente g
CROSS JOIN media_gasto m
WHERE g.gasto_total > m.media
ORDER BY g.gasto_total DESC;
-- CTEs encadenadas: análisis de clientes frecuentes y su producto favorito
WITH pedidos_por_cliente AS (
    SELECT cliente_id, COUNT(*) AS num_pedidos, SUM(total) AS gasto
    FROM pedidos
    GROUP BY cliente_id
),
clientes_frecuentes AS (
    SELECT cliente_id
    FROM pedidos_por_cliente
    WHERE num_pedidos >= 5
),
producto_mas_comprado AS (
    SELECT
      pe.cliente_id,
      pr.nombre AS producto_favorito,
      SUM(lp.cantidad) AS unidades_totales,
      ROW_NUMBER() OVER (
        PARTITION BY pe.cliente_id
        ORDER BY SUM(lp.cantidad) DESC
      ) AS rn
    FROM lineas_pedido lp
    JOIN pedidos pe  ON pe.id = lp.pedido_id
    JOIN productos pr ON pr.id = lp.producto_id
    WHERE pe.cliente_id IN (SELECT cliente_id FROM clientes_frecuentes)
    GROUP BY pe.cliente_id, pr.id, pr.nombre
)
SELECT
  c.nombre,
  pc.num_pedidos,
  pc.gasto,
  pm.producto_favorito
FROM clientes c
JOIN pedidos_por_cliente pc    ON pc.cliente_id = c.id
JOIN producto_mas_comprado pm  ON pm.cliente_id = c.id AND pm.rn = 1
ORDER BY pc.gasto DESC;
Subconsultas en INSERT, UPDATE y DELETE
Las subconsultas no son exclusivas del SELECT. También puedes usarlas en sentencias de modificación de datos.
-- INSERT: copiar clientes sin pedidos a una tabla de seguimiento
INSERT INTO clientes_sin_actividad (cliente_id, nombre, email, fecha_registro)
SELECT id, nombre, email, NOW()
FROM clientes
WHERE id NOT IN (
    SELECT DISTINCT cliente_id FROM pedidos WHERE cliente_id IS NOT NULL
);
-- UPDATE: aplicar descuento del 10% a los productos que no se han vendido en 6 meses
UPDATE productos
SET precio = precio * 0.90
WHERE id NOT IN (
    SELECT DISTINCT lp.producto_id
    FROM lineas_pedido lp
    JOIN pedidos pe ON pe.id = lp.pedido_id
    WHERE pe.fecha >= DATE_SUB(NOW(), INTERVAL 6 MONTH)
    AND lp.producto_id IS NOT NULL
);
-- UPDATE con subconsulta en el SET: actualizar el total de un pedido
UPDATE pedidos
SET total = (
    SELECT SUM(cantidad * precio_unit)
    FROM lineas_pedido
    WHERE pedido_id = pedidos.id
)
WHERE estado != 'completado';
-- DELETE: eliminar pedidos de clientes que han sido eliminados del sistema
DELETE FROM pedidos
WHERE cliente_id NOT IN (
    SELECT id FROM clientes
);
Rendimiento: cuándo usar subconsultas y cuándo no
Las subconsultas son muy expresivas pero no siempre son la opción más eficiente. Aquí las claves para tomar buenas decisiones.
Las subconsultas correlacionadas son las más costosas. Se ejecutan una vez por cada fila de la consulta exterior. Si tu tabla tiene un millón de filas y usas una subconsulta correlacionada, esa subconsulta se ejecuta un millón de veces. En la mayoría de los casos, un JOIN o una CTE es más eficiente.
-- LENTO: subconsulta correlacionada que se ejecuta por cada cliente
SELECT nombre,
       (SELECT COUNT(*) FROM pedidos p WHERE p.cliente_id = c.id) AS num_pedidos
FROM clientes c;

-- RÁPIDO: JOIN con agrupación, una sola pasada por los datos
SELECT c.nombre, COUNT(p.id) AS num_pedidos
FROM clientes c
LEFT JOIN pedidos p ON p.cliente_id = c.id
GROUP BY c.id, c.nombre;
EXISTS es casi siempre más rápido que IN con subconsultas grandes, porque EXISTS se detiene en cuanto encuentra la primera coincidencia, mientras que IN tiene que evaluar toda la lista.
-- Menos eficiente con tablas grandes
SELECT nombre FROM clientes
WHERE id IN (SELECT cliente_id FROM pedidos);

-- Más eficiente: EXISTS se detiene en la primera coincidencia
SELECT nombre FROM clientes c
WHERE EXISTS (SELECT 1 FROM pedidos p WHERE p.cliente_id = c.id);
Usa EXPLAIN para diagnosticar el rendimiento de tus consultas. Te muestra el plan de ejecución y dónde el motor de base de datos está haciendo un escaneo completo de tabla en lugar de usar un índice.
-- Ver el plan de ejecución de cualquier consulta
EXPLAIN SELECT c.nombre
FROM clientes c
WHERE EXISTS (
    SELECT 1 FROM pedidos p WHERE p.cliente_id = c.id
);

-- En MySQL puedes pedir más detalle con EXPLAIN ANALYZE
EXPLAIN ANALYZE SELECT ...
Los índices son clave. Las columnas usadas en los WHERE de las subconsultas deben estar indexadas, especialmente las claves foráneas.
-- Asegúrate de tener índices en las columnas de join y filtro
CREATE INDEX idx_pedidos_cliente_id  ON pedidos(cliente_id);
CREATE INDEX idx_pedidos_fecha       ON pedidos(fecha);
CREATE INDEX idx_lineas_pedido_id    ON lineas_pedido(pedido_id);
CREATE INDEX idx_lineas_producto_id  ON lineas_pedido(producto_id);
Resumen: cuándo usar cada tipo
| Tipo de subconsulta | Devuelve | Se usa con | Cuándo usarla |
|---|---|---|---|
| Escalar | Un valor | =, >, <, SELECT | Comparar con un agregado o un único valor calculado |
| Lista con IN | Varias filas | IN, NOT IN | Filtrar por pertenencia a un conjunto. Cuidado con NULLs en NOT IN |
| EXISTS | Booleano | EXISTS, NOT EXISTS | Comprobar existencia. Más seguro y eficiente que IN con tablas grandes |
| ANY / ALL | Varias filas | > ANY, > ALL | Comparar contra un rango de valores de otra consulta |
| Correlacionada | Depende | WHERE, SELECT, HAVING | Cálculos que dependen de cada fila. Úsala con moderación por el coste |
| Tabla derivada | Una tabla | FROM | Pre-agregar datos antes de filtrar o unir con otras tablas |
| CTE (WITH) | Una tabla con nombre | WITH ... SELECT | Alternativa legible a subconsultas anidadas. Preferida en consultas complejas |
No hay comentarios todavía. Sé el primero en compartir tu opinión.